用人工智能做演示:结构、幻灯片文字和配图
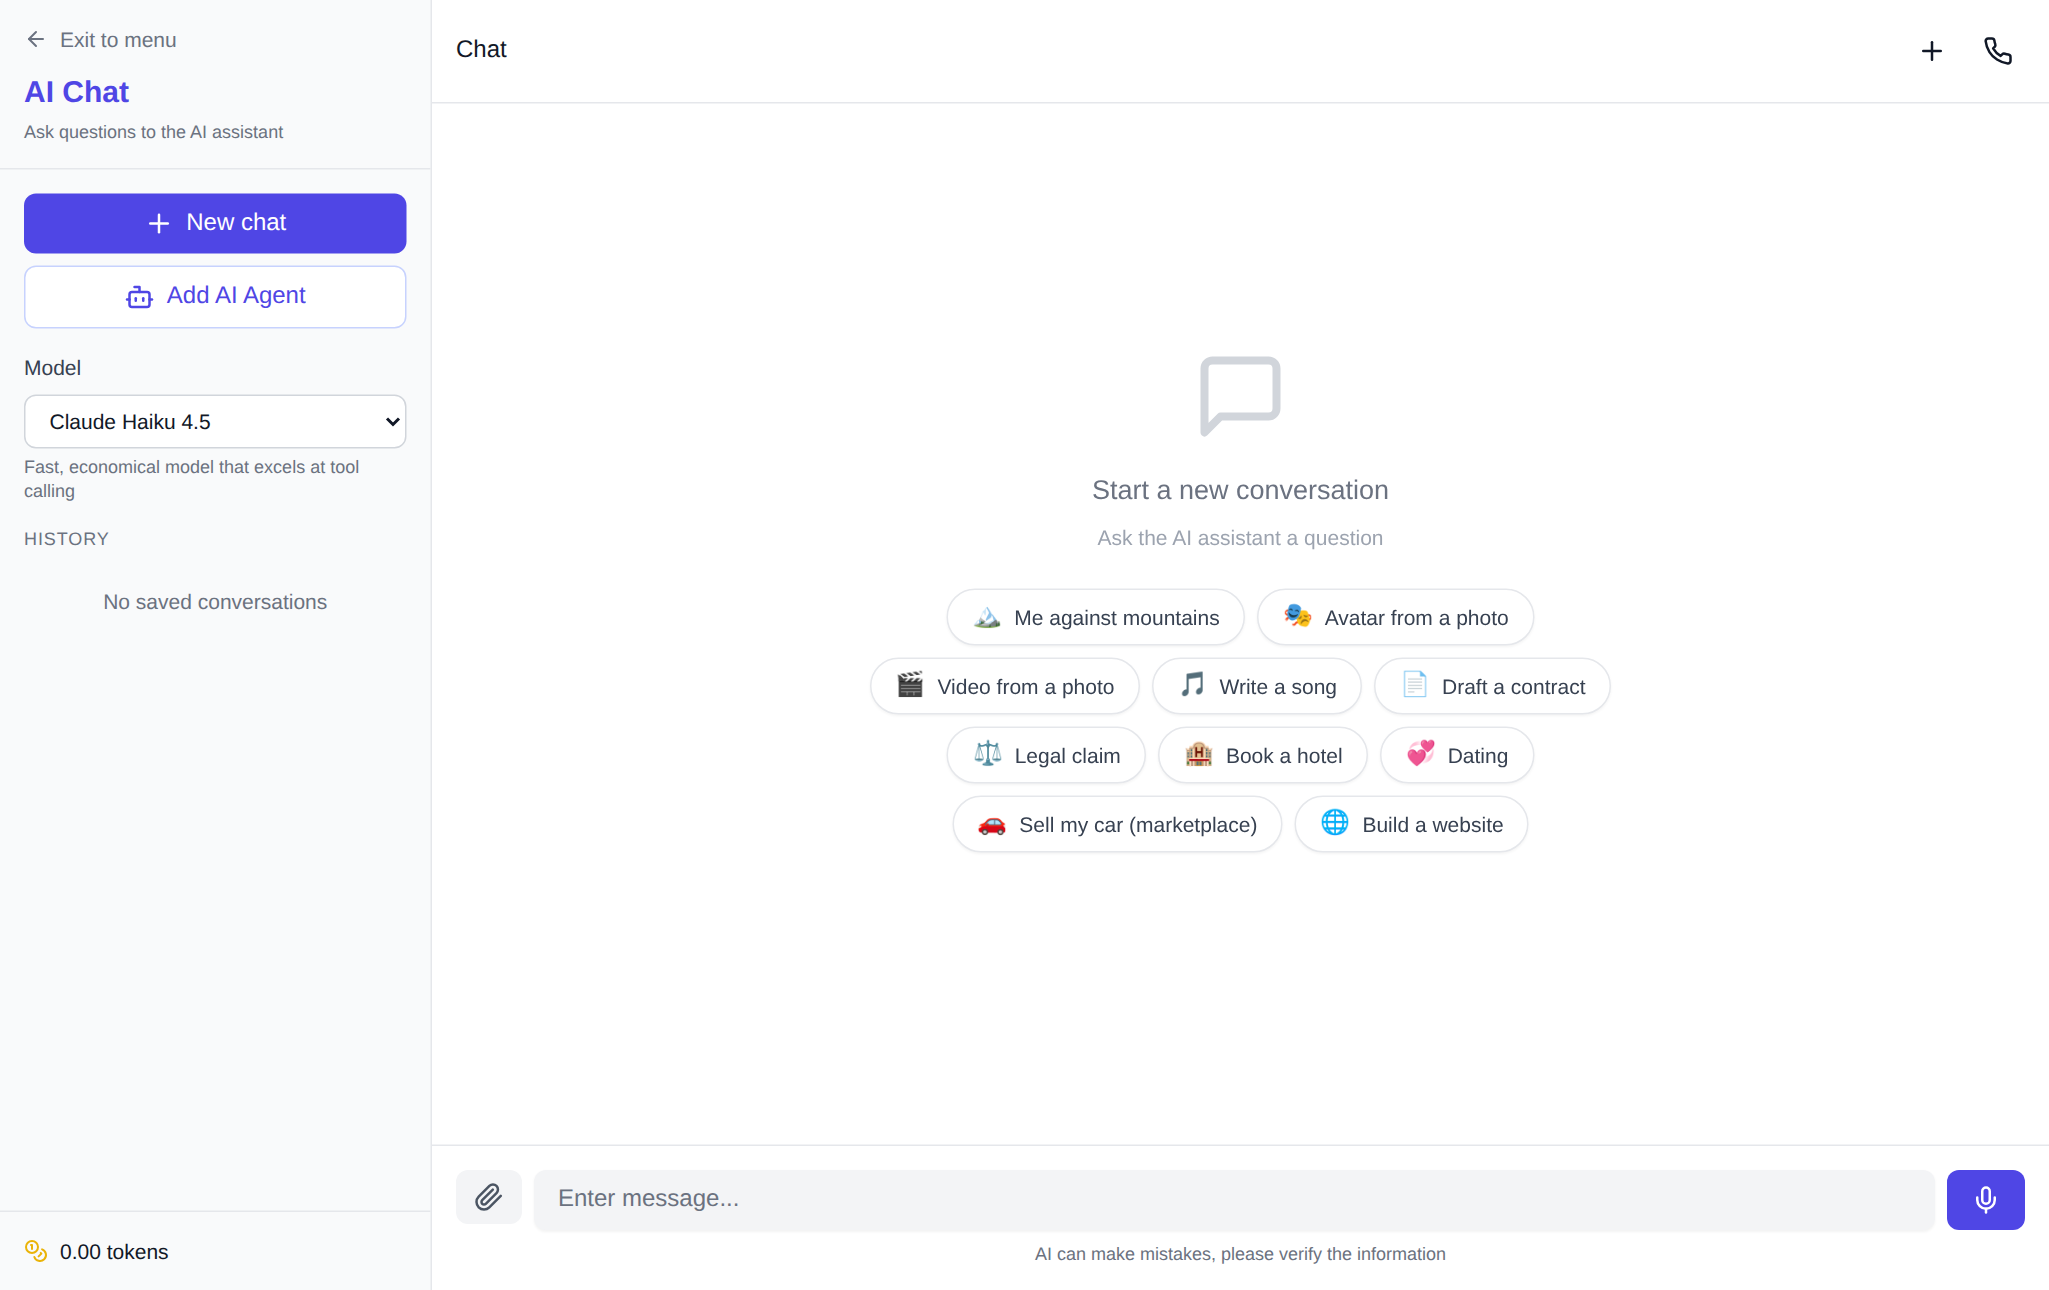
用人工智能做演示不是按一个按钮,而是两步配合:聊天里的语言模型负责起草结构、编写幻灯片标题、要点和演讲备注,图片生成器负责画插图,取代素材库的图标。在 NeuralSpace 上需要两个页面:聊天 /chat 和图片生成器 /genimages。下面是一套可执行的工作流程、现成的提示词模板,以及来自网站近 14 天真实统计的两个数据。
第一步:结构和幻灯片文字——在聊天里
聊天板块汇集了语言模型(Claude、ChatGPT、DeepSeek 等),接管最费时的一部分。可以发送类似这样的请求:
帮我准备一份 10 页的演示文稿,主题是“…”,面向受众“…”。每一页请写:标题、三个简短要点、两三句演讲备注,以及一句简短描述——说明图片模型可以画一张什么样的插图。
常见的错误是让模型“一次性做完整个演示”。分工具工作效果明显更好:模型负责含义和结构,你决定保留什么、砍掉什么、按什么顺序讲。修改就在同一对话里继续提——“把第三页精简一下”“把例子换成国内市场的”——模型记得整份演示的上下文,只重写你点到的部分。还有一条值得一开始就说清楚:不要在插图描述里包含幻灯片上的文字,字幕类内容最后在 PowerPoint 或 Google Slides 里手动输入,这样最清晰。
第二步:幻灯片配图——在 /genimages
幻灯片插图由图片生成器完成。背景和装饰性图形用 Nano Banana 2 和 Seedream 4.5 效果不错;如果图上必须有文字,选 ChatGPT Images 2.5 或 Nano Banana 2.1——它们对文字的还原能力最好,不过短语字幕还是建议在成品图上手动补上。演示幻灯片请选 16:9 比例。这是网站最活跃的板块:根据近 14 天的内部生成统计,用户成功生成了 6,112 张图片,最常用的是 GPT Image 1.5、Nano Banana 2 和 Seedream 4.5(数据来源:NeuralSpace 生成日志,样本为 14 天)。
幻灯片插图的提示词模板
一份框架通吃整份演示,只需替换主体内容:
为幻灯片“…”画一幅浅色背景的扁平极简插图:主体为“…”,几个大块柔和的强调形状,柔和的粉彩配色,干净的构图,不要文字、字母和标志。
要少要细节:一页塞满十个对象的场景在幻灯片上只会变成噪点。一张清晰的中心图胜过拥挤的拼贴——含义交给幻灯片本身的文字和图表。
开始之前要知道的事
- 内容审核。同样在这 14 天里,6,425 次生成尝试中有 313 次被拒绝,约 5%,大多数是被敏感内容自动过滤器拦下(数据来源:NeuralSpace 生成日志,样本为 14 天)。如果提示词涉及医疗、体育或敏感情境中的人物,换个更中性的说法——通常重试一次即可。
- 耗时。单张图片从几十秒到两分钟不等,视模型而定,一份 10 页的演示给插图预留大约十分钟。
- 风格统一。所有页面的提示词都必须复用同一个框架(只换中心主体),这样整套图看起来才像一份演示,而不是杂乱的拼贴。
页数很多?用 API
想用一个脚本生成三十张插图,NeuralSpace 通过公开的API对外开放:同样的模型目录,按代币计费,无需订阅。密钥相关的常见问题见同页的文档。
常见问题
AI 会自己拼好 .pptx 文件吗?
不会:聊天返回文字,生成器返回图片,最终拼装由 PowerPoint、Google Slides 或 Keynote 完成。实践中这反而是优点——设计由你控制,而不是得到一个千篇一律的机器模板。
哪个模型写图上文字最好?
ChatGPT Images 2.5 和 Nano Banana 2.1 对文字的还原能力优于目录里其他模型,不过短字幕还是建议在成品图上手动输入,最稳妥。
要花多少钱?
生成按代币计费,没有订阅:新用户会获得初始代币,之后按用量付费。所选模型和画质消耗的代币数,在板块页面上启动前就能直接看到。