视频 AI:文本生成视频、照片动效与多语言配音
现代视频 AI 已经能够完整覆盖视觉创作的全流程:不仅可以通过文字描述从零生成电影级镜头(Text-to-Video),还能将静态肖像或插画转化为生动的动态画面(Image-to-Video),甚至能够将现成视频翻译为多国语言并精准同步人物唇形(Lip-Sync)。在 NeuralSpace 的「视频」板块中,集成了全球主流的前沿视频生成模型,包括 SeeDance 系列(2.5、2.0、1.5 Pro)、Kling 3.0、Grok Video、VEO 3 以及 Wan 2.6。本文将系统拆解如何根据具体任务挑选合适模型、如何撰写高命中率的提示词,以及如何利用真实渲染基准规避常见报错。
三大主流视频生成形态
AI 视频技术已彻底脱离了早期粗糙的短循环动图阶段,在实际生产中主要分为三大模式:
- 文生视频(Text-to-Video)。无需任何现成素材,直接通过自然语言生成电影级空镜、动态背景和广告创意分镜。模型会依据文本自动构建三维空间几何、光影分布、材质质感与摄影机运动轨迹。
- 图生视频与照片动效(Image-to-Video)。上传静态照片、插画或产品渲染图,由模型补充自然的动态维度:水流微波、云雾飘散、微风拂动发丝或人物自然微笑。其核心优势在于完美锁定原图的人格特征与艺术画风。
- 视频翻译、配音与唇形同步(Video-to-Video / Lip-Sync)。将原视频中的人物语音翻译为目标语种,同时自动重绘嘴部肌肉运动,让口型与新音轨严丝合缝,无需重复录制即可完成出海本土化。
NeuralSpace 真实渲染速度与稳定性数据
视频渲染对算力要求极高,生成耗时与任务类型直接相关。根据 NeuralSpace 生产管线在过去 90 天内(2026 年 7 月 15 日至 10 月 15 日,基于 video_generations 匿名日志中 9,194 项视频生成任务)的聚合数据,全平台视频生成的综合成功率达到 69.1%(累计产出 6,357 条完整视频)。
各分类的耗时与性能基准如下:
- 照片动效与图生视频(Image-to-Video)是平台最受欢迎的工作流,产出 3,384 条成功片段。平均单次生成耗时为 125.4 秒(约 2 分钟出头),是高效率内容生产的首选。
- 文生视频(Text-to-Video)由于需要全流程物理计算,896 次成功任务的平均耗时为 258.2 秒(约 4.3 分钟)。其中 Kling 3.0 与 Grok Text-to-Video 表现出极高的技术稳定性,任务完成率分别达到 81.4% 和 83.8%。
- 视频加工与唇形配音任务平均耗时为 333.4 秒(约 5.5 分钟),主要归因于音画逐帧对齐与面部高保真重建。
分析用户端的失败记录发现,除供应商瞬时网络抖动外,最常见的未完成原因为提示词触发自动化安全审核策略(153 起)以及严格人脸识别规则拦截(18 起)。规范提示词表述能有效提高生成成功率。
如何写出高质感的视频提示词
与静态生图不同,视频提示词必须交代“时间维度上的演变”。一条标准的视频提示词包含五个基本要素:
- 景别与机位:特写镜头(Close-up)、低角度仰拍、第一视角穿梭飞行。
- 主体描述:人物特征、道具材质与具体场景空间。
- 动作与物理表现:明确具体发生的变化(例如“浪花猛烈撞击黑色湿润岩石并扬起白色水雾”,而不是笼统的“壮丽大海”)。
- 运镜方式:缓慢推近(push-in)、弧线环绕运镜(arc shot)、水平平移(pan)。
- 光影与胶片质感:黄昏暖光、逆光轮廓、35mm 胶片颗粒感。
在为已有照片制作动效时,切忌重复描述画面中已存在的衣服颜色或五官外形;图生视频提示词只需聚焦动态:“人物微微露齿微笑,眼神移向镜头,微风轻轻吹动发丝,镜头缓慢向前推移”。
在 NeuralSpace 快速上手生成视频
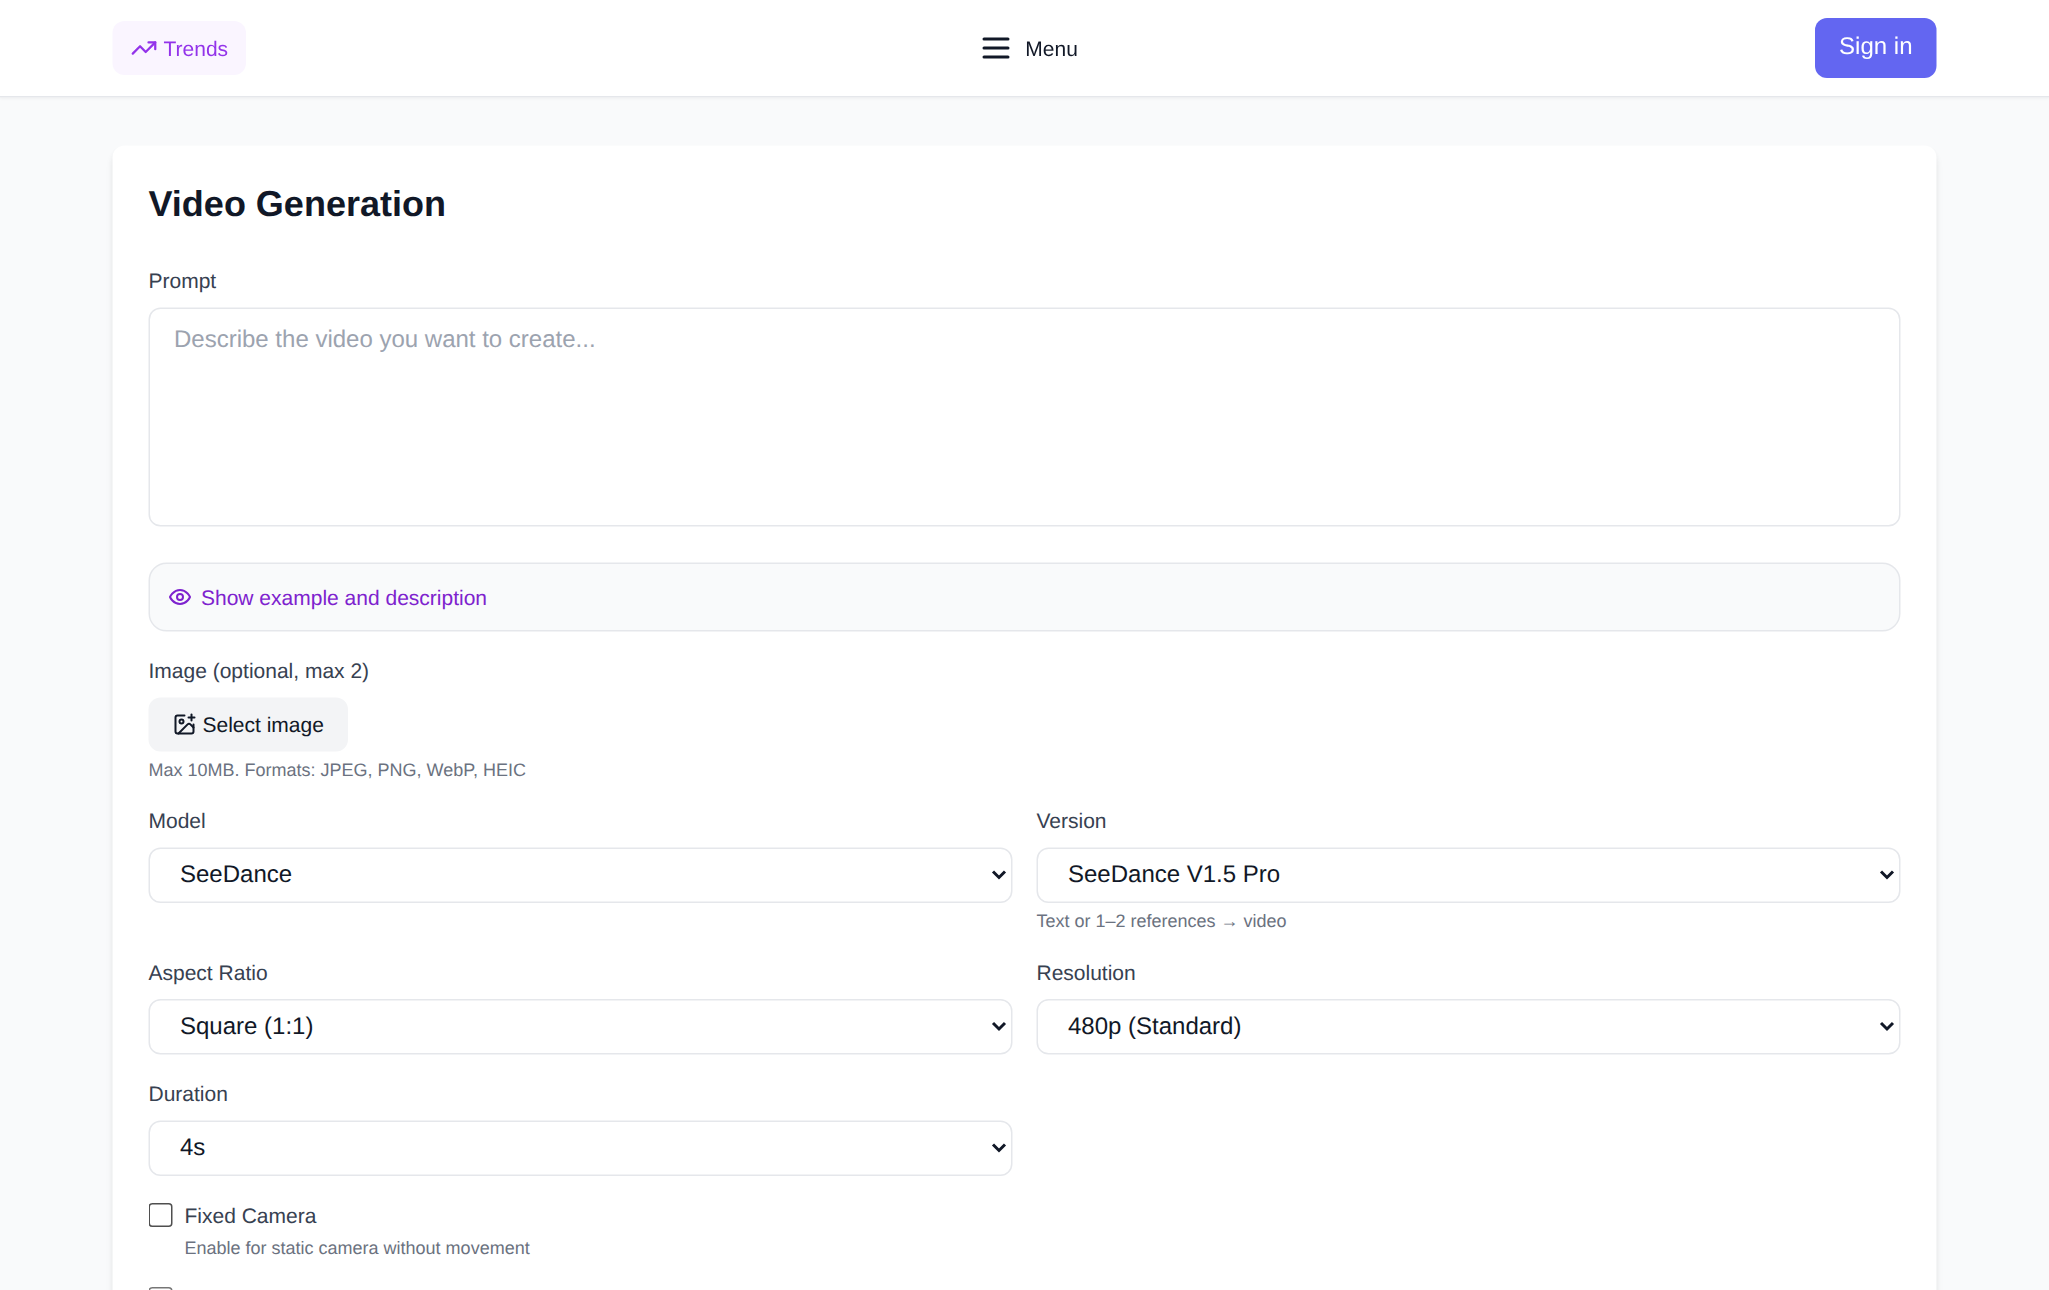
在 NeuralSpace 上创作视频无需搭建本地显卡驱动或部署复杂的工作流软件:
- 进入网站的「视频」板块。
- 选择对应模式:从零起步选择 Text-to-Video;制作照片动态则直接将图片拖拽至输入区。
- 根据需求匹配模型(长片段与声音选 SeeDance 2.5,写实人物动态首选 Kling 3.0,照片动效选 Grok 或 Wan 2.6)。
- 调整参数规格:画面比例(横屏 16:9,竖屏 Reels/Shorts 选 9:16),设定生成时长及清晰度(草稿选 720p,成品推荐 1080p)。
- 点击「生成视频」按钮。所需 token 消耗在启动前直接明晰显示在按钮上。
渲染完成后,视频会直接显示在结果卡片中,并永久收录在您的个人生成历史中,支持随时下载为 MP4 文件。NeuralSpace 全程无强制性按月订阅:新用户注册即可获得初始 token 用于体验各项功能,后续按实际消耗 token 计费。
针对不同场景该选哪个模型?
不同模型各有擅长领域:如果需要生成长达 30 秒、带原生音效及最多 30 个图文参考的高自由度片段,SeeDance 2.5 是最佳方案;如果追求极其写实的人物肢体语言、行走物理与手指细节,Kling 3.0 表现最为稳健;若需快速为海报或静物照片注入鲜活生机且不破坏原本画风,Grok Image-to-Video 与 Wan 2.6 则是兼顾速度与美感的首选。
常见问题解答
哪款 AI 模型最适合制作照片动态效果?
Kling 3.0 和 Grok Image-to-Video 在照片动态化方面综合表现最优。它们能够严格锁定原图面部结构,同时模拟自然的眨眼、呼吸与光影流动。
文生视频与图生视频的核心区别是什么?
文生视频完全由模型从无到有脑补构图与角色;图生视频则以原图作为起始帧,仅计算帧与帧之间像素的位移动态,画面可控性更高。
AI 生成一段视频通常需要多长时间?
结合 NeuralSpace 平台的实际运行数据,照片动效的平均等待时间为 125.4 秒(约 2 分钟),文生视频平均耗时为 258.2 秒(约 4.3 分钟)。
在 NeuralSpace 生成视频是否需要按月订阅?
不需要。平台不设包月订阅,新用户注册即可领取初始 token 体验,后续按需充值并按单次生成的 token 消耗计费。