用 AI 让照片动起来:从静态图到动态短片
用 AI 让照片动起来,就是把一张静态照片变成几秒钟的动态短片:人物眨眼或转头,水面泛起波纹,镜头缓慢推进。技术上这叫 image-to-video:模型不是去修图,而是在画面里补上原本不存在的运动。在 NeuralSpace 上这件事在「视频」板块几步就能完成。下面说明该选哪个模型、什么样的照片动起来效果好,以及怎样用文字把运动描述清楚,免得反复重做。
「让照片动起来」是什么意思,又不是什么
image-to-video 拿一张现成画面当起点,补出后面发生的事:镜头运动、面部表情、光与水的流动。它既不是修复也不是放大——那些工具提升的是照片本身的细节,并不增加时间。动起来是在时间维度上工作:输出是一段短片,通常按模型不同为 4 到 30 秒。要记住,模型会自行编造画面里没有的东西,所以原图越干净、越简单,运动就越可信。
什么样的照片效果好
有个简单规律:一个清晰的主体处于焦点。半身人像、单独一个人物、前景鲜明的风景、中性背景上的商品,动起来都可预期。最难的是远景群像,以及同一画面里有几个同等重要主体的照片:模型会把所有人一起糊掉。发皱、偏暗或噪点很大的原图也能动,但脸上容易出现瑕疵。如果照片很旧有破损,先用修复工具处理,再拿来动。
在 NeuralSpace 上让照片动起来:分步操作
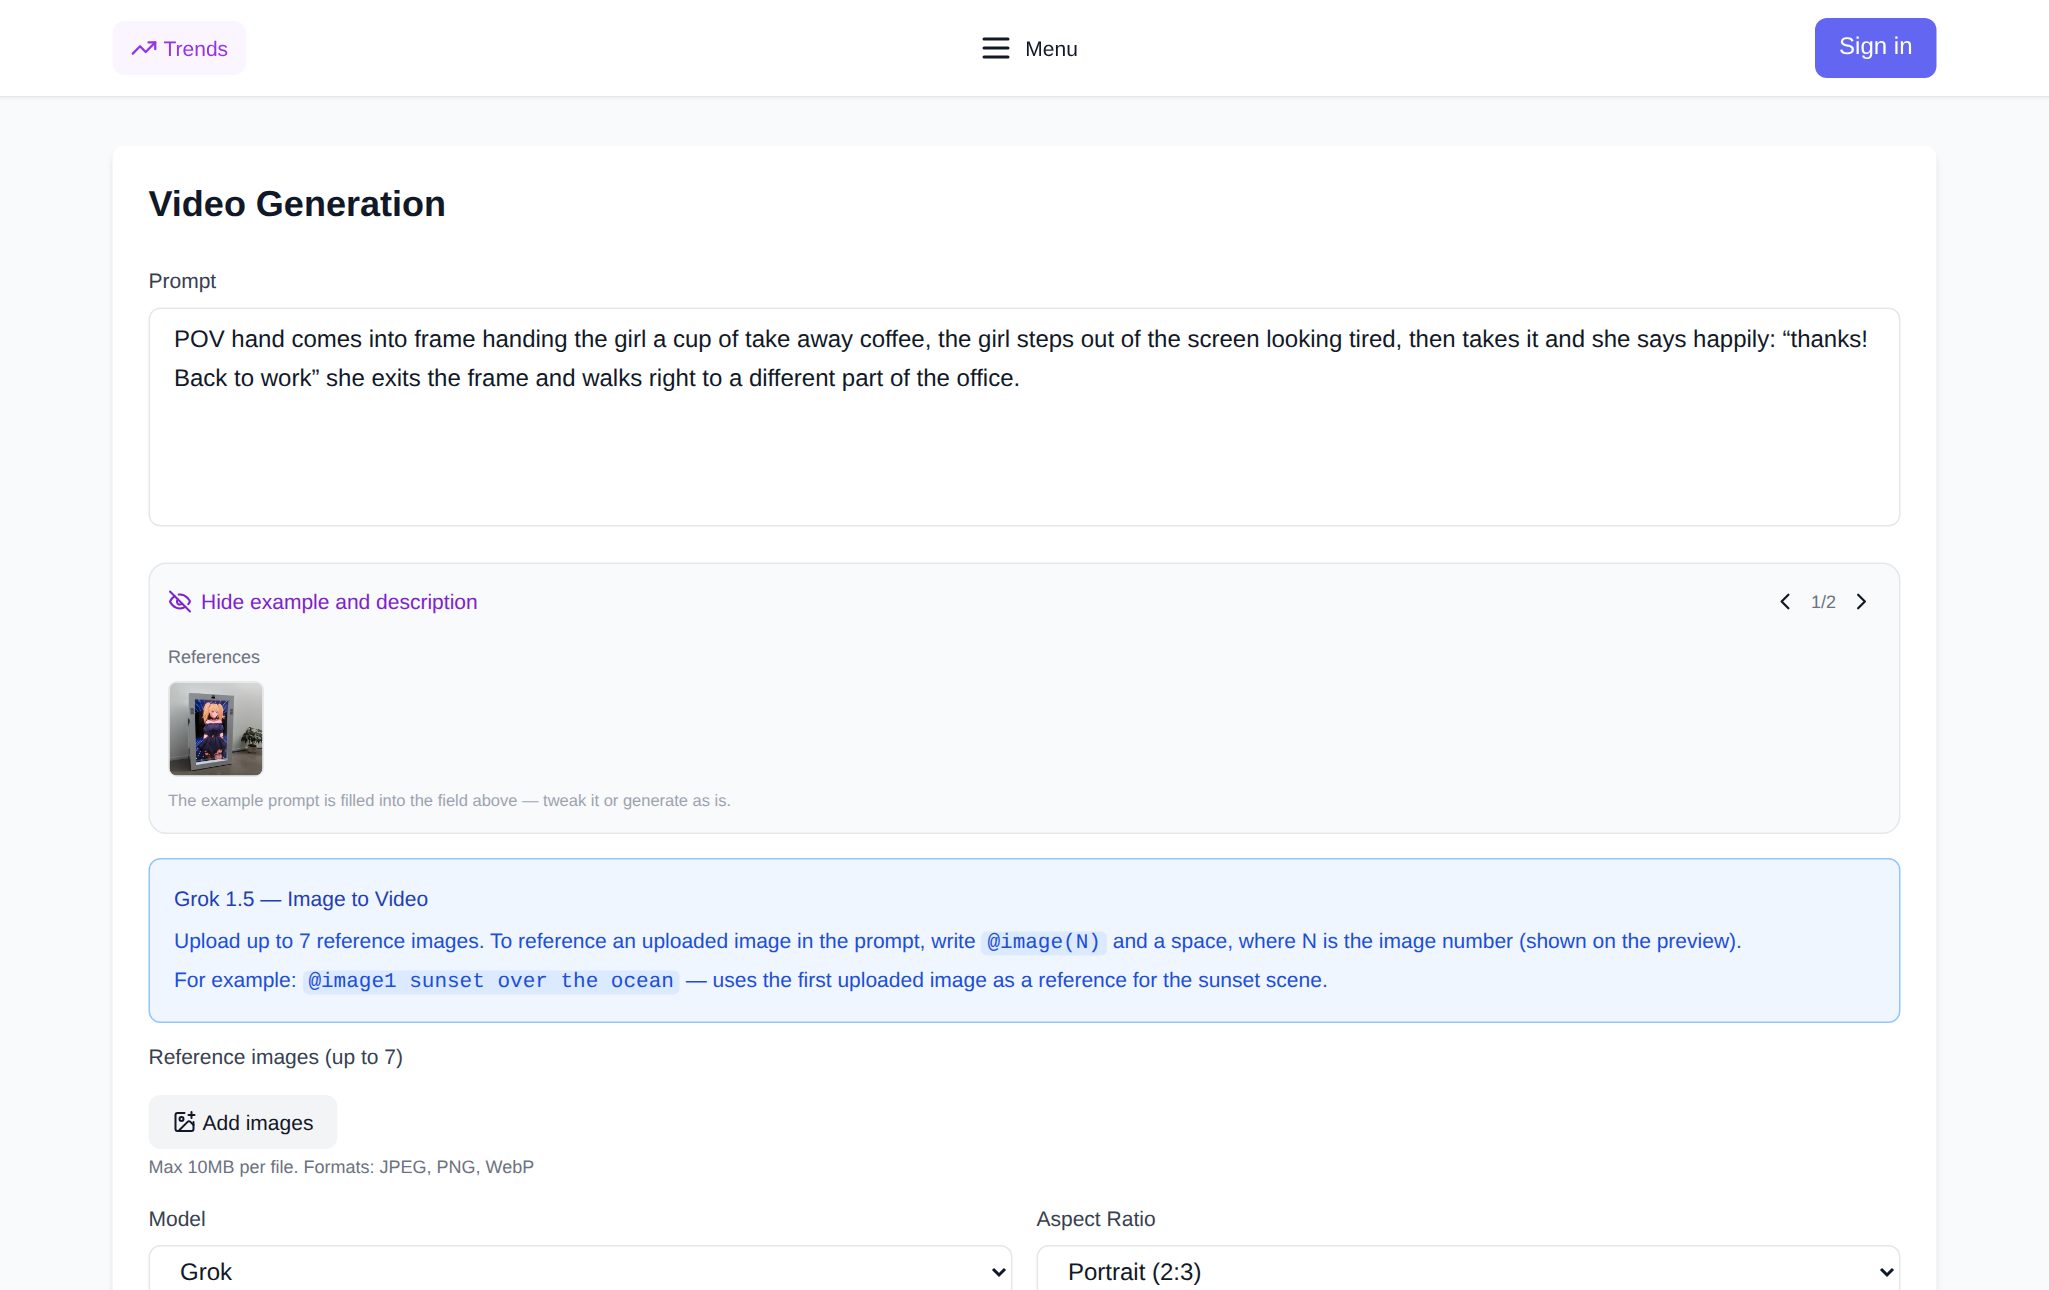
整个过程只要几分钟。打开「视频」板块,选择一个 image-to-video 模型。然后点击图片按钮上传照片,用文字描述想要的运动,需要时设置时长和分辨率,再开始生成。完成的短片会出现在历史记录里,可以直接下载。无需安装或配置:全部在浏览器中运行。
该选哪个模型
目录里有多个接受图片输入的模型,各有特点:
- SeeDance 2.5 —— 通用之选:接受文本、图片和视频,时长 4–30 秒。需要可预期的镜头和主体运动时很合适。
- SeeDance V1.5 Pro —— 一到两个参考图的简单路径,适合快速出结果。
- Kling O1 Image-to-Video —— 专为图片设计,适合让人像和物体动起来。
- Kling 3.0 与 Turbo —— 文本和图片转视频(std / pro),Turbo 更快。
- VEO 3.1 与 Sora 2 —— 「文本或图片转视频」的强通用模型。
- MiniMax H3 —— 支持带声音的视频,4–15 秒,最高 2K。
- HappyHorse 1.0 —— 图片加文本,独立的 image-to-video 路径。
如果需要的不是单纯的运动,而是会说话的人像,请选「图片 + 音频转说话头像」模型(Kling AI Avatar、OmniHuman 1.5),或用 Wan 2.2 Animate 从视频参考里迁移运动。
怎样用文字描述运动
提示词要描述照片里没有的东西,也就是运动。不要写「让它动」,而要具体、只给一个动作:「微风拂动头发,镜头缓慢推进」「水面泛起波纹,云从右向左飘动」「人物平静地眨眼并微微一笑」。一条提示里塞的运动越多,结果越抖动,所以只保留一个主要动作。镜头的方向和速度也最好直接写清楚。
多少钱
NeuralSpace 没有订阅:新用户会获得初始 token,之后按 token 付费。价格取决于模型、时长和分辨率,并在开始前显示,因此在片子开始渲染前就能看到成本。为了避免花两次钱,每次只改一个参数。
常见问题
可以让照片动起来免费吗?
没有长期免费的生成入口。新用户会获得初始 token 用来试用工具,之后按 token 计费,无需订阅。
人像用哪个模型好?
人像适合 Kling O1 Image-to-Video 和 SeeDance 2.5——在轻微运动时能较好地保住脸。会说话的人像则需要单独的「图片 + 音频」模型。
结果有多长?
取决于模型:SeeDance 2.5 为 4 到 30 秒,MiniMax H3 为 4 到 15 秒。短片比长片动得更稳。
需要会剪辑吗?
不需要。你上传照片、描述运动,就得到成品文件。生成后即可下载短片。