Vem talade när gratis: röstseparation och live undertexter
Efter ett möte, en intervju eller en föreläsning står du kvar med en inspelning där flera personer pratar, och en vanlig utskrift kan inte berätta vem som sa vad. Vem talade när är ett gratis webbläsarverktyg: det delar upp inspelningen i talare (upp till fyra), förvandlar valfritt talet till en tidsstämplad dialog och dess andra flik kör livetextning direkt från din mikrofon. Filen laddas aldrig upp, inga tokens spenderas och inget konto behövs.
Hur det fungerar
Röstseparationen drivs av NVIDIA Sortformer-modellen: den hittar upp till fyra talare och anger hur lång tid var och en hördes. Om du lämnar rutan "Transkribera också talet" markerad, får orden som fästs vid talarna - du får en dialogutskrift märkt "Speaker 1", "Speaker 2" och på, som du kan kopiera eller ladda ner som TXT, SRT, VTT eller JSON. Ett märke bredvid tidslinjen visar hur många talare modellen hittade.
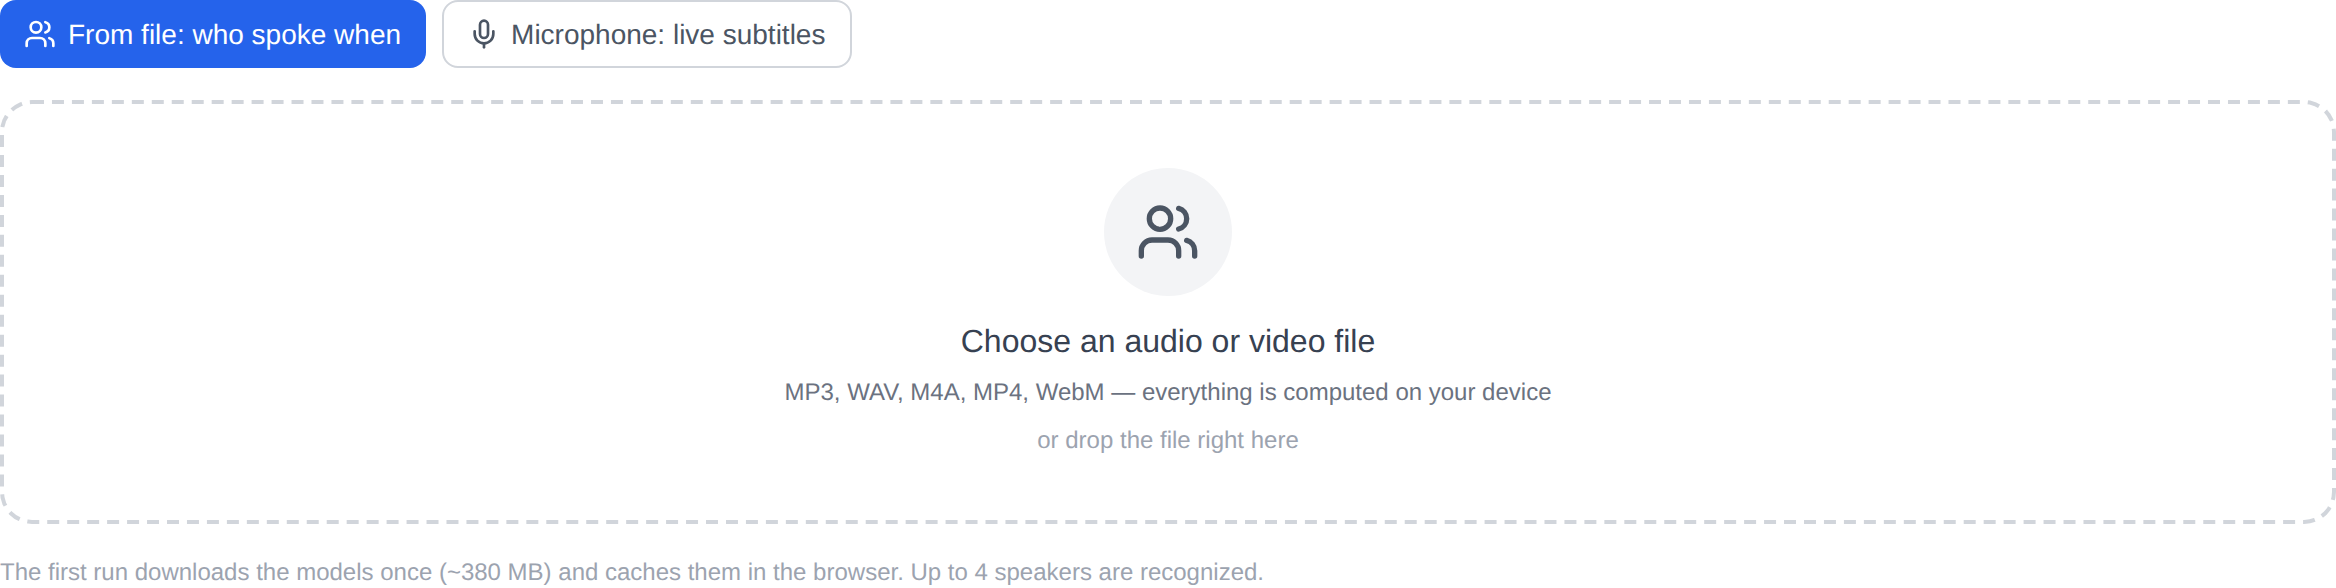
Den första körningen laddar ner modellvikterna till din enhet - cirka 380 MB totalt. Efter det förblir de cachade i din webbläsare och senare körs behöver inget nätverk. Med ett grafikkort (WebGPU) går analysen snabbt; utan den faller motorn tillbaka till processorn (WASM) — märkbart långsammare, men resultatet är detsamma, och verktyget kommer att berätta när det händer. Ljudet fälls ner till 16 kHz mono inuti webbläsaren; ingenting behöver spelas in någonstans.
Markera din egen inspelning
- Öppna verktyg och välj en ljud- eller videofil: MP3, WAV, M4A, MP4 och WebM accepteras, och du kan släppa filen i ramen.
- Bestäm rutan "Transkribera också talet": markerad, det ger dig en tidsstämplad dialog; avmarkerad, bara tidslinjen "vem och när talade".
- Tryck på startknappen. Vid första körningen, vänta tills modellerna laddas ner - förloppsindikatorn håller dig uppdaterad.
- Resultatet är tidslinjen plus dialogen. Kopiera texten med en knapp eller ladda ner den i det format du behöver.
Livetextning från mikrofonen
Den andra fliken tar ljud direkt från mikrofonen och textar det fras för fras medan du talar: den aktuella frasen visas stora, färdiga finns kvar i listan nedan. Det passar ett möte, en föreläsning eller ett videosamtal, när textning behövs nu snarare än efter bearbetning av en fil. Mikrofonåtkomst begärs genom att trycka på knappen; ingenting skrivs till en fil och ingenting lämnar webbläsaren.
Vad man ska veta i förväg
Verktyget är ungt och experimentellt: kvaliteten på separationen beror på inspelningen. Rena mikrofonsamtal delas upp med självförtroende, medan bullriga, ekande inspelningar med ständiga avbrott kan förvirra det. Talarbete tar också minne – planera för cirka 1 GB utrymme. På processorbanan (WASM) tar en lång inspelning märkbart längre tid än på ett grafikkort. Modellen lär sig inga namn: etiketterna "Speaker 1" och "Speaker 2" är avsedda att bytas om efter export, för att matcha dina minuter.
Vem behöver det
En journalist kan snabbt hitta var en ny röst kommer in i en intervju. En student kan lägga upp en föreläsningsinspelning rad för rad: var professorn talade och var publiken frågade. En poddredigerare kan lokalisera sträckorna av en lång session där alla pratade över varandra och klippte ut dem. En mötessekreterare kan bygga ett utkast till protokoll med tidskoder utan att skicka inspelningen någonstans.
När du behöver något annat
Om det du vill ha är vanlig text snarare än en röstuppdelning, öppna ljud och video → text. De andra verktygen i sektionen lever på Audio sida och fler gratis lokala verktyg finns under Andra verktyg. Analysen görs av det öppna FluidAudio-biblioteket (MIT-licens): koden och modellerna finns i din webbläsare, utan omvägar till andra servrar.