Бесплатно претражите текст по значењу
У дугом уговору, клаузула казне се може назвати „казном“, али у скици одговор на питање није нимало близак речима којима га тражите. Бесплатно претраживање текста по значењу проналази одговарајуће фрагменте документа и приказује их по степену подударања. Можете тражити тачне речи или прећи на семантичку претрагу. Текст остаје у претраживачу, токени се не отписују.
Када редовна претрага странице не помаже
Обезбедите двадесет страница записника са састанка. Сећате се да је тим одложио објављивање апликације, али се фраза „датум пуштања“ тамо не појављује. Претраживање речи неће вратити ништа. У семантичком режиму, упит за „када се издаје“ може довести до параграфа „покретање је померено за следећу недељу“ — чак и ако је формулација другачија.
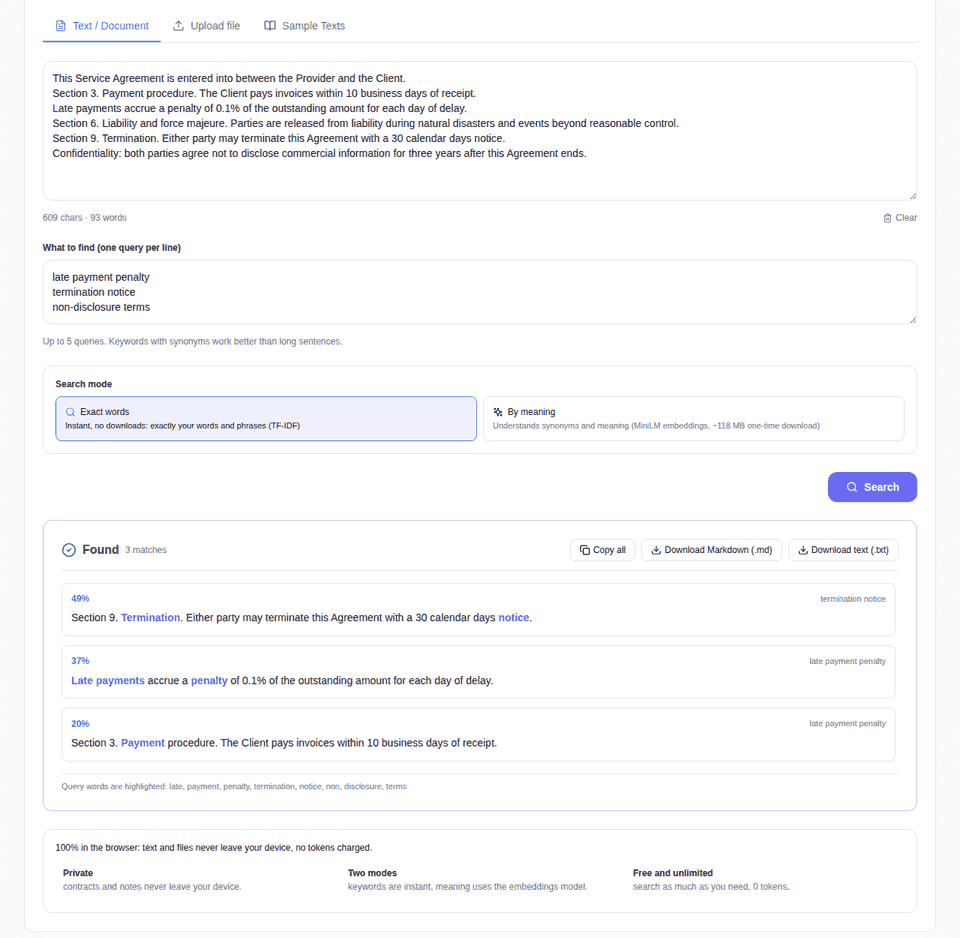
Алат има два режима. „Ворд Тачно“ повезује упите са фрагментима на основу речи и њихове тежине, тако да ради одмах, без учитавања модела. „По значењу“ упоређује нумеричке приказе текста које гради вишејезични МиниЛМ модел. Његови фајлови заузимају око 118 МБ: прво покретање захтева преузимање, следеће могу да раде из кеша чак и без мреже. За кратак, једноставан документ, први режим је обично бржи; за синониме је кориснији други.
Како проверити свој документ
- Отвори алат за претрагу и налепите текст. Можете да отпремите ТКСТ, Маркдовн, ХТМЛ или ПДФ са текстуалним слојем. Датотека се чита на вашем уређају.
- Унесите упите – по један по реду, до највише пет. На пример: „новчана казна за кашњење“, „како раскинути уговор“.
- Изаберите претрагу по речима или значењу и кликните на „Пронађи“. Резултат ће показати одговарајуће пасусе, проценат сличности и упит са којим је сваки одломак повезан.
- Потребни фрагменти се могу одмах копирати или сачувати у ТКСТ и Маркдовн.
Постоје три готова примера: уговор, белешке о истраживању и записник са састанка. Згодно је почети са њима да бисте видели разлику између режима без припреме сопствене датотеке. Прво бих проверио упит у брзом режиму и укључио семантички ако документ користи другачију терминологију.
Шта се дешава са текстом
Документ је подељен на мале фрагменте, након чега претрага процењује њихову близину упитима и сортира подударања. Сва обрада се одвија у вашем претраживачу; текст и датотека се не шаљу на сервер. Ово је згодно за радне белешке и уговоре које не желите да отпремате у ћаскање треће стране. Алат је такође доступан гостима.
Подржан је текст дужине до 200.000 знакова. За претрагу је потребно најмање 80 знакова, а ПДФ мора имати текст који се може издвојити: алат неће читати скениране странице без текстуалног слоја. На великом документу семантички режим може потрајати дуже, посебно на слабијем уређају. Проценат сличности помаже да се сортира оно што је пронађено, али ово није процена поузданости - важан услов је и даље да се поново прочита у оригиналном контексту.
На пример, у извештају о истраживању можете засебно да питате о повећању тачности модела и уштеди времена лекара. Услуга ће приказати релевантне одломке једног документа, чак и ако се налазе на различитим страницама. Али не проверава бројеве са спољним изворима и не пише закључак уместо вас: требало би да отворите пронађене редове у оригиналном ПДФ-у и проверите на које искуство и период се односе.
Ако вам је потребан другачији резултат
Овде је задатак пронаћи права места уз одржавање текста документа. Ако желите кратак резиме целе странице или ПДФ уместо листе подударања, покушајте гуја. А за друге локалне алате отворите одељак "Други алати". Претрага по значењу је спремна: убаците документ и покушајте са једним конкретним питањем.