Поиск в тексте по смыслу бесплатно
В длинном договоре условие о штрафе может называться «неустойкой», а в конспекте ответ на вопрос — стоять совсем не рядом с теми словами, которыми вы его ищете. Бесплатный поиск в тексте по смыслу находит подходящие фрагменты документа и показывает их по степени совпадения. Можно искать точные слова или переключиться на смысловой поиск. Текст остаётся в браузере, токены не списываются.
Когда обычный поиск по странице не помогает
Представьте протокол встречи на двадцать страниц. Вы помните, что команда перенесла выпуск приложения, но фраза «срок релиза» там не встречается. Поиск по словам вернёт пустоту. В смысловом режиме запрос «когда выпуск» может привести к абзацу «запуск перенесён на следующую неделю» — даже если формулировки различаются.
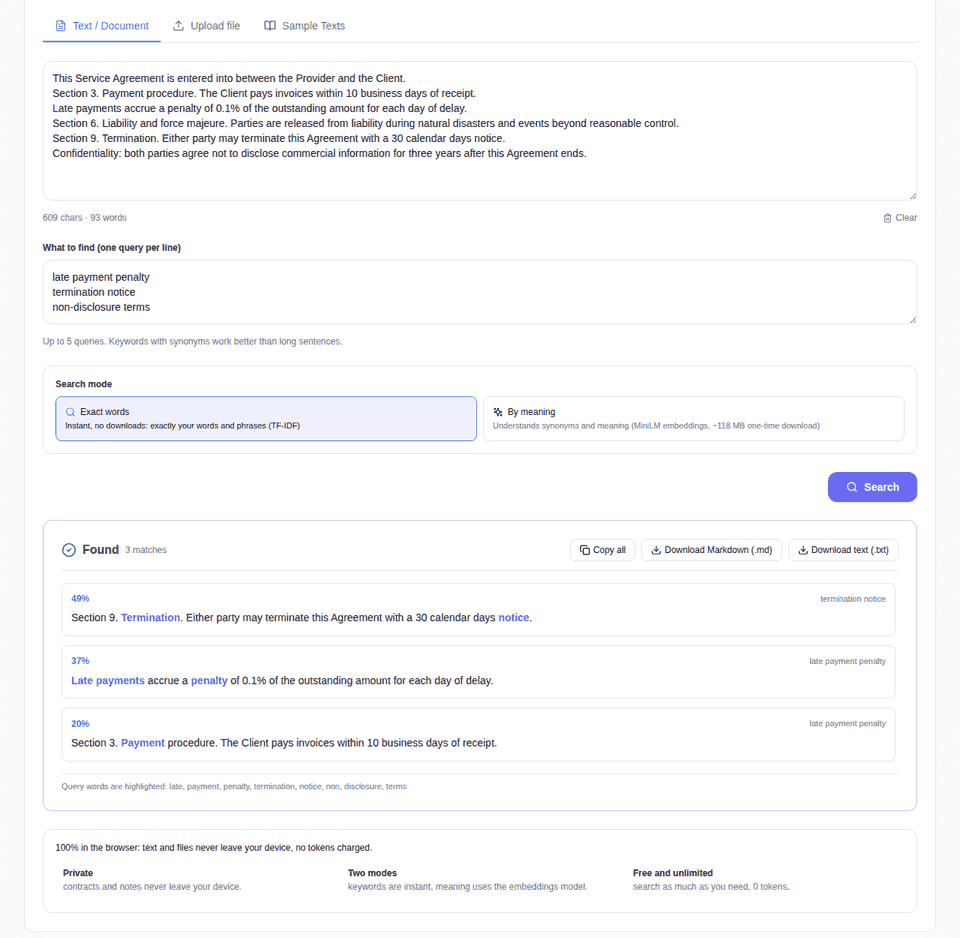
У инструмента два режима. «Точно по словам» сопоставляет запросы с фрагментами по словам и их весам, поэтому работает сразу, без загрузки модели. «По смыслу» сравнивает числовые представления текста, которые строит мультиязычная модель MiniLM. Её файлы занимают около 118 МБ: первый запуск требует загрузки, следующие могут работать из кэша даже без сети. Для короткого простого документа первый режим обычно быстрее; для синонимов полезнее второй.
Как проверить свой документ
- Откройте инструмент поиска и вставьте текст. Можно загрузить TXT, Markdown, HTML или PDF с текстовым слоем. Файл читается на вашем устройстве.
- Введите запросы — по одному на строку, максимум пять. Например: «штраф за задержку», «как расторгнуть договор».
- Выберите поиск по словам или по смыслу и нажмите «Найти». Результат покажет подходящие отрывки, процент сходства и запрос, с которым связан каждый отрывок.
- Нужные фрагменты можно скопировать сразу или сохранить в TXT и Markdown.
Есть три готовых примера: договор, исследовательские заметки и протокол встречи. С них удобно начать, чтобы увидеть разницу режимов без подготовки своего файла. Я бы сперва проверил запрос в быстром режиме, а смысловой включил, если документ использует другую терминологию.
Что происходит с текстом
Документ разбивается на небольшие фрагменты, после чего поиск оценивает их близость к запросам и сортирует совпадения. Вся обработка идёт в вашем браузере; текст и файл не отправляются на сервер. Это удобно для рабочих заметок и договоров, которые не хочется загружать в сторонний чат. Гостю инструмент тоже доступен.
Поддерживается текст длиной до 200 000 знаков. Для поиска нужно минимум 80 знаков, а у PDF должен быть извлекаемый текст: скан страниц без текстового слоя инструмент не прочитает. На большом документе смысловой режим может считать дольше, особенно на слабом устройстве. Процент сходства помогает отсортировать найденное, но это не оценка достоверности — важное условие всё равно перечитайте в исходном контексте.
Например, в исследовательском отчёте можно отдельно спросить о росте точности модели и об экономии времени врача. Сервис покажет соответствующие отрывки одного документа, даже если они находятся на разных страницах. Но он не сверяет цифры с внешними источниками и не пишет за вас вывод: найденные строки стоит открыть в исходном PDF и проверить, к какому опыту и периоду они относятся.
Если нужен другой результат
Здесь задача — найти нужные места, сохранив формулировки документа. Если вместо списка совпадений нужна короткая выжимка всей страницы или PDF, попробуйте суммаризатор. А для других локальных инструментов откройте раздел «Другие инструменты». Поиск по смыслу уже готов: вставьте документ и попробуйте один конкретный вопрос.