Кто когда говорил бесплатно: разделение голосов и субтитры
После любой записи с двумя и более голосами остаётся один и тот же вопрос: «а это кто сказал?». Кто когда говорил (бесплатно) отвечает на него прямо в браузере: инструмент находит границы реплик, раскладывает их по говорящим — «Спикер 1», «Спикер 2» и так далее, до четырёх человек, — и при желании добавляет к этому текст. Файл никуда не загружается, токены не списываются, регистрация не нужна.
Как работает разделение голосов
Задача называется диаризацией: модель слушает весь поток звука и отвечает на два вопроса отдельно — «кто звучал» и «в какие минуты». Голоса сравниваются по характеристике тембра, поэтому реплики одного человека собираются в одну дорожку даже если вы говорите вперемешку. В результате получается таймлайн: каждая строка — реплика со своими метками времени и номером спикера.
Всё считается на вашем устройстве. Модели один раз скачиваются в браузер и дальше работают без сети; на видеокарте через WebGPU разбор идёт заметно быстрее, если браузер её не отдаёт — на процессоре через WASM, корректно, но неспешно. Прежде чем начинать длинную запись, посмотрите предупреждение о памяти: для комфортной работы нужно около гигабайта.
Разобрать файл по шагам
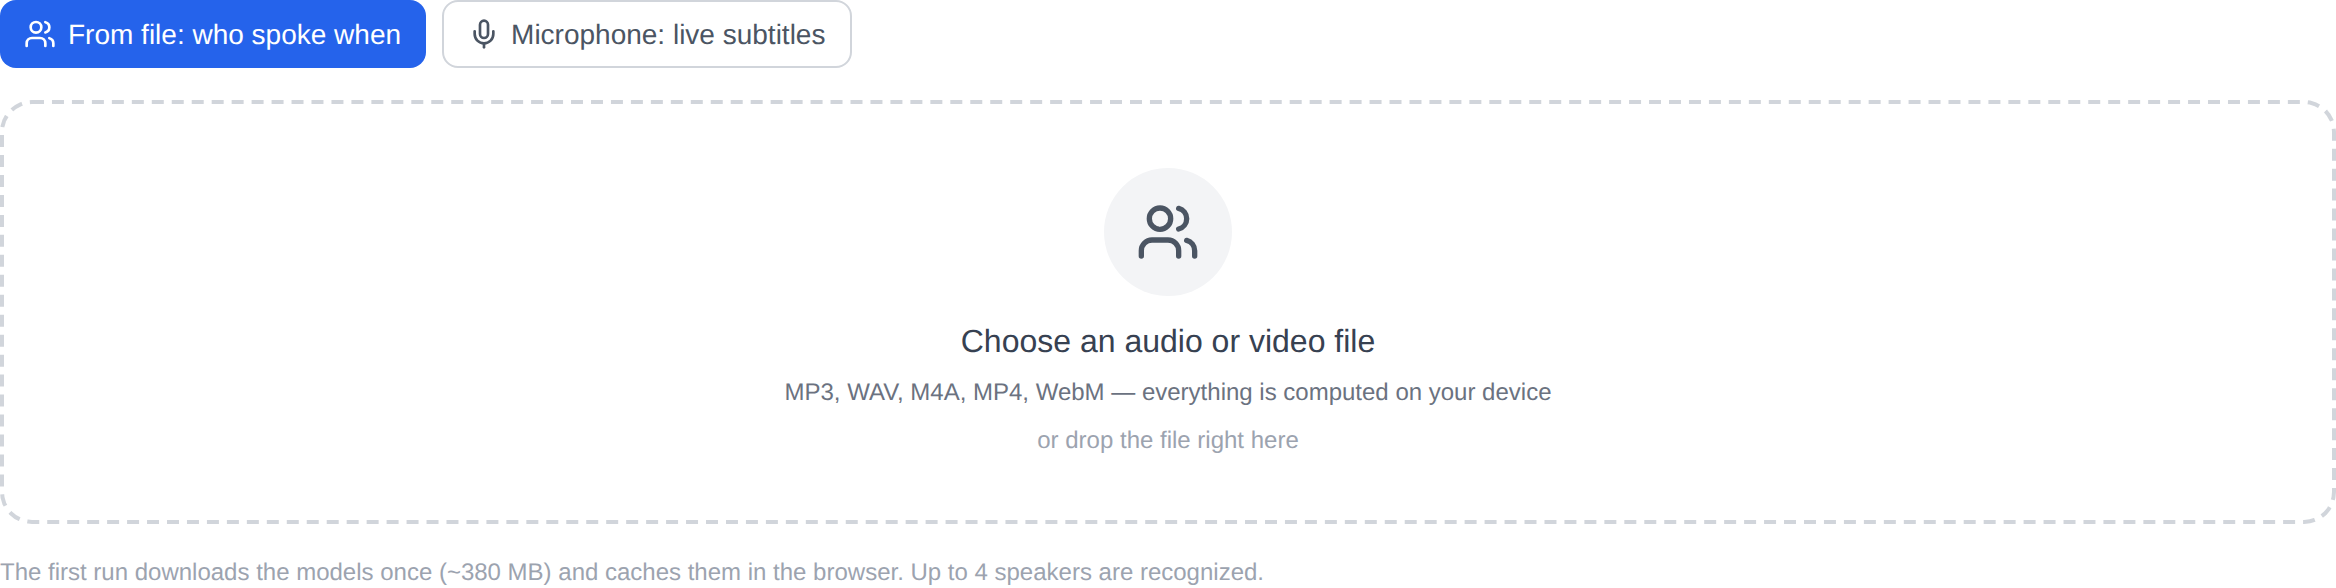
- Откройте инструмент и на вкладке «Файл» выберите запись: подойдут MP3, WAV, M4A, MP4, WebM и другие медиа.
- Галочка «Также распознать речь» подключает расшифровку текста: слова лягут на дорожки спикеров и соберутся в читаемый диалог. Если она снята, запись только разложится по голосам — это быстрее.
- Первый запуск скачивает модели (около 380 МБ) и кеширует их; следующие разборы начинаются с ходу.
- Дождитесь таймлайна и диалога, затем скопируйте результат или выгрузите его в TXT, SRT, VTT или JSON. В субтитрах SRT и VTT у каждой реплики стоит её спикер — такой файл сразу подключается к видеоредактору.
Живые субтитры с микрофона
Вторая вкладка работает без файла: включите микрофон — и фразы начнут появляться на экране по ходу речи. Законченная фраза уходит в список с меткой времени, следующая набирается следом. Звук при этом не записывается и не уходит на сервер: субтитры живут только на вашей странице, проверить можно в любой момент через вкладку сети в инструментах разработчика. Удобно для созвонов, собраний и лекций, когда расшифровка нужна по ходу разговора, а не после него.
Честные границы
Это инструмент разделения голосов, а не универсальный расшифровщик. Модель распознавания речи обучена в первую очередь на английской речи: диалог по-русски она расшифрует, но с большим числом ошибок, чем англоязычный. До четырёх говорящих различаются надёжно; запись из шумного зала с перебивками разберётся хуже, чем спокойное интервью. Расшифровка с голосами — не замена профессиональному транскрибированию, её результат стоит вычитывать, прежде чем отдавать дальше.
Ещё ограничение — железо: слабому устройству может не хватить памяти под модели, и разбор на процессоре занимает ощутимое время. Зато цена определённая — ноль: ни очередей, ни списаний, ни загрузки на сервер.
Кому это подходит
Журналисту — быстро понять структуру интервью и вычленить цитаты. Ведущему встреч — получить протокол «кто и что сказал» без ручной прокрутки записи. Монтисту — подключить субтитры с именами спикеров к видео через SRT/VTT. Студенту — разобрать лекцию на реплики и тезисы.
Если текст нужен без разделения по голосам и на многих языках, рядом работает распознавание речи (бесплатно). Остальные модели раздела собраны на странице «Аудио», а бесплатные локальные инструменты — в разделе «Другие инструменты». Начните с короткой записи минут на пять: первого запуска с загрузкой моделей хватит, чтобы понять, как звучат ваши записи в разборе.