Cine a vorbit când gratis: separarea vocii și subtitrări live
După o întâlnire, un interviu sau o prelegere rămâi cu o înregistrare în care mai multe persoane vorbesc, iar o transcriere obișnuită nu-ți poate spune cine a spus ce. Cine a vorbit când este un instrument gratuit de browser: împarte înregistrarea în vorbitori (până la patru), opțional transformă discursul într-un dialog marcat de timp, iar a doua filă rulează subtitrări live direct din microfon. Fișierul nu este încărcat niciodată, nu sunt cheltuite jetoane și nu este nevoie de cont.
Cum funcționează
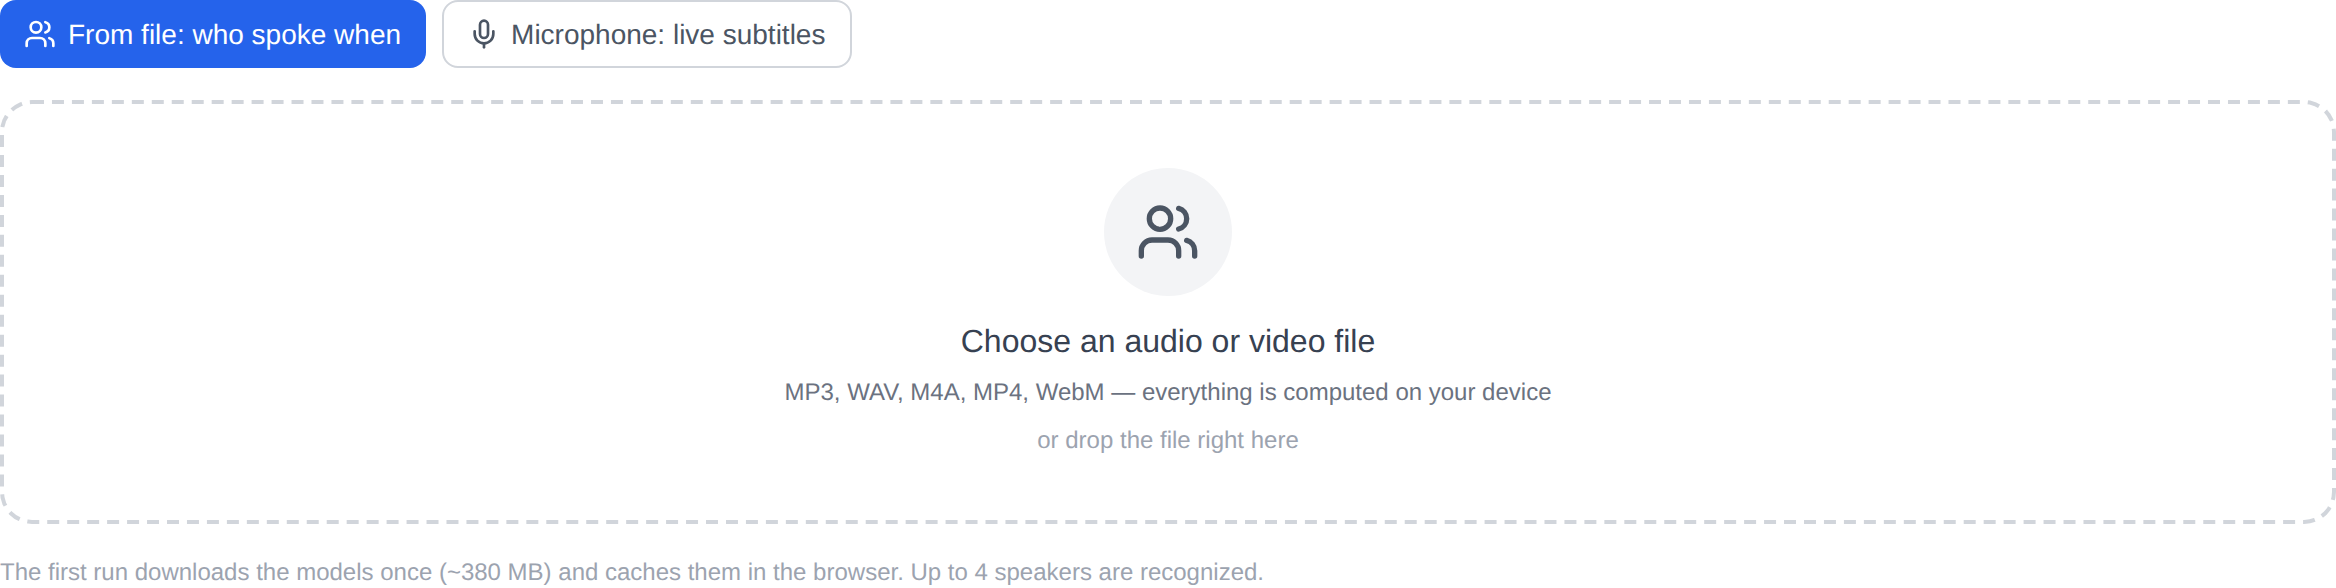
Separarea vorbitorilor este alimentată de modelul NVIDIA Sortformer: găsește până la patru vorbitori și stabilește intervalele de timp în care fiecare a fost auzit. Dacă lăsați bifată caseta „Transcrieți și discursul”, cuvintele se atașează vorbitorilor — veți obține o transcriere a dialogului etichetată „Vorbitor 1”, „Vorbitor 2” și mai departe, pe care o puteți copia sau descărca ca TXT, SRT, VTT sau JSON. O insignă de lângă cronologia arată câte vorbitori a găsit modelul.
Prima rulare descarcă greutățile modelului pe dispozitivul dvs. - aproximativ 380 MB în total. După aceea, acestea rămân în cache în browser-ul dvs. și rulările ulterioare nu au nevoie de rețea. Cu o placă grafică (WebGPU) analiza este rapidă; fără el, motorul cade înapoi la procesor (WASM) — vizibil mai lent, dar rezultatul este același, iar instrumentul vă va spune când se întâmplă acest lucru. Audio este pliat la 16 kHz mono în interiorul browserului; nimic nu are nevoie de înregistrare nicăieri.
Marcarea propriei înregistrări
- Deschideți instrument și alegeți un fișier audio sau video: MP3, WAV, M4A, MP4 și WebM sunt acceptate și puteți arunca fișierul pe cadru.
- Decideți căsuța „Transcrieți și discursul”: bifată, vă oferă un dialog marcat cu ora; nebifat, doar cronologia „cine și când a vorbit”.
- Apăsați butonul de pornire. La prima rulare, așteptați să se descarce modelele - bara de progres vă ține la curent.
- Rezultatul este cronologia plus dialogul. Copiați textul cu un buton sau descărcați-l în formatul de care aveți nevoie.
Subtitrări live de la microfon
A doua filă preia sunetul direct de la microfon și îl subtitră frază cu frază în timp ce vorbiți: fraza curentă apare mare, cele terminate rămân în lista de mai jos. Se potrivește unei întâlniri, o prelegere sau un apel video, atunci când sunt necesare subtitrări acum, mai degrabă decât după procesarea unui fișier. Accesul la microfon este solicitat prin apăsarea butonului; nimic nu este scris într-un fișier și nimic nu părăsește browserul.
Ce să știi dinainte
Instrumentul este tânăr și experimental: calitatea separării depinde de înregistrare. Conversațiile cu microfon curate se împart cu încredere, în timp ce înregistrările zgomotoase, cu ecou, cu întreruperi constante, o pot deruta. Lucrul de vorbire necesită, de asemenea, memorie — planificați aproximativ 1 GB de spațiu liber. Pe calea procesorului (WASM), o înregistrare lungă durează mult mai mult decât pe o placă grafică. Modelul nu învață numele: etichetele „Speaker 1” și „Speaker 2” sunt menite să fie redenumite după export, pentru a se potrivi cu minutele dvs.
Cine are nevoie
Un jurnalist poate găsi rapid unde o nouă voce intră într-un interviu. Un student poate pune o prelegere înregistrând rând cu rând: unde a vorbit profesorul și unde a întrebat publicul. Un editor de podcast poate localiza perioadele unei sesiuni lungi în care toată lumea a vorbit unul peste altul și le poate tăia. Un secretar al ședinței poate construi o schiță a procesului-verbal cu coduri de timp fără a trimite înregistrarea oriunde.
Când ai nevoie de altceva
Dacă ceea ce doriți este text simplu, mai degrabă decât o defalcare prin voce, deschideți audio și video → text. Celelalte instrumente ale secțiunii trăiesc pe Audio pagina, iar mai multe instrumente locale gratuite sunt sub Alte instrumente. Analiza se face prin biblioteca deschisă FluidAudio (licență MIT): codul și modelele locuiesc în browser-ul dvs., fără ocoliri către alte servere.