Kto mówił, kiedy za darmo: separacja głosu i napisy na żywo
Po spotkaniu, rozmowie kwalifikacyjnej czy wykładzie zostaje Ci nagranie, na którym rozmawia kilka osób, a zwykły zapis nie jest w stanie powiedzieć, kto co powiedział. Kto kiedy mówił to bezpłatne narzędzie przeglądarkowe: dzieli nagranie na mówców (maksymalnie cztery), opcjonalnie zamienia mowę w dialog ze znacznikiem czasu, a druga zakładka wyświetla napisy na żywo prosto z Twojego mikrofonu. Plik nigdy nie jest przesyłany, nie są wydawane żadne tokeny i nie jest potrzebne żadne konto.
Jak to działa
Separacja mówców opiera się na modelu NVIDIA Sortformer: wyszukuje do czterech mówców i określa przedziały czasu, w których każdy z nich był słyszalny. Jeśli pozostawisz zaznaczone pole „Transkrypuj także mowę”, słowa zostaną przypisane do mówców — otrzymasz transkrypcję dialogów oznaczoną jako „Mówca 1”, „Mówca 2” i dalej, którą możesz skopiować lub pobrać jako TXT, SRT, VTT lub JSON. Plakietka obok osi czasu pokazuje, ile mówców znalazł model.
Przy pierwszym uruchomieniu pobierane są wagi modeli na Twoje urządzenie — łącznie około 380 MB. Następnie pozostają w pamięci podręcznej przeglądarki, a późniejsze uruchomienia nie wymagają sieci. W przypadku karty graficznej (WebGPU) analiza jest szybka; bez tego silnik cofa się do procesora (WASM) — zauważalnie wolniej, ale wynik jest taki sam, a narzędzie poinformuje Cię, kiedy to nastąpi. Dźwięk w przeglądarce jest obniżany do 16 kHz mono; nic nie wymaga nigdzie nagrywania.
Zaznaczanie własnego nagrania
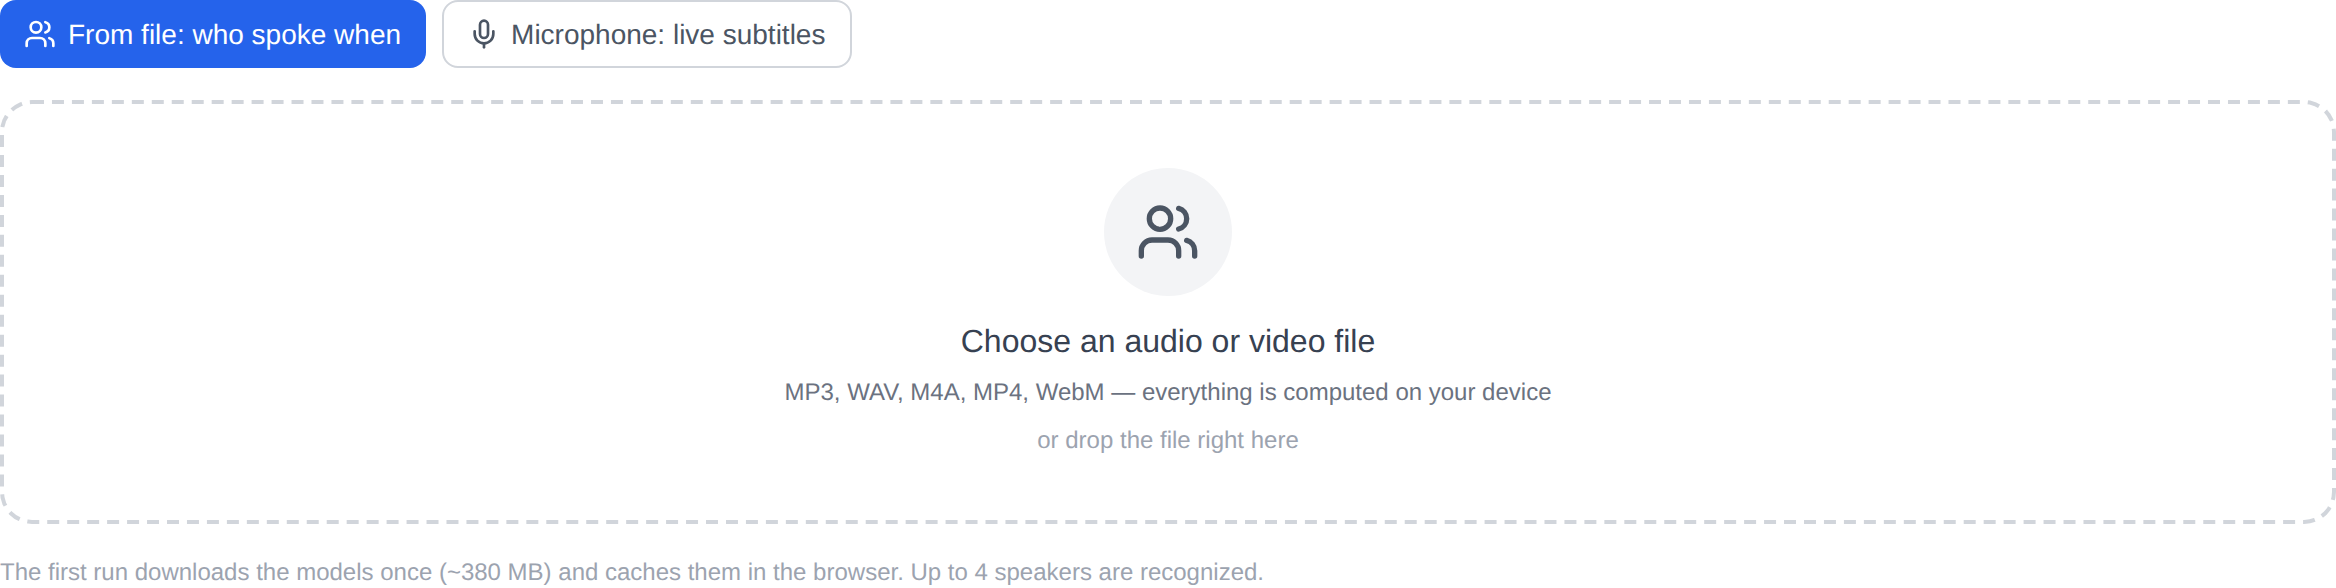
- Otwórz narzędzie i wybierz plik audio lub wideo: MP3, WAV, M4A, MP4 i WebM zostaną zaakceptowane i możesz upuścić plik na ramkę.
- Wybierz pole „Transkrypuj także mowę”: zaznaczone, wyświetli dialog ze znacznikiem czasu; niezaznaczone, jedynie oś czasu „kto i kiedy mówił”.
- Naciśnij przycisk startu. Przy pierwszym uruchomieniu poczekaj na pobranie modeli — pasek postępu informuje Cię o postępie.
- Rezultatem jest oś czasu i dialog. Skopiuj tekst za pomocą przycisku lub pobierz go w potrzebnym formacie.
Napisy na żywo z mikrofonu
Druga zakładka pobiera dźwięk prosto z mikrofonu i opisuje go fraza po frazie podczas mówienia: bieżąca fraza jest wyświetlana w dużych rozmiarach, gotowe pozostają na poniższej liście. Sprawdzi się na spotkaniu, wykładzie lub rozmowie wideo, gdy napisy potrzebne są teraz, a nie po przetworzeniu pliku. Aby uzyskać dostęp do mikrofonu, należy nacisnąć przycisk; nic nie jest zapisywane do pliku i nic nie opuszcza przeglądarki.
Co warto wiedzieć wcześniej
Narzędzie jest młode i eksperymentalne: jakość separacji zależy od nagrania. Czyste rozmowy mikrofonowe dzielą się pewnie, a hałaśliwe nagrania z echem i ciągłymi przerwami mogą je dezorientować. Praca z mową wymaga również pamięci — zaplanuj około 1 GB wolnego miejsca. Na ścieżce procesora (WASM) długie nagrywanie trwa zauważalnie dłużej niż na karcie graficznej. Model nie uczy się nazw: nazwy etykiet „Mówca 1” i „Mówca 2” należy po wyeksportowaniu zmienić, aby dopasować je do minut.
Kto tego potrzebuje
Dziennikarz może szybko znaleźć miejsce, w którym w wywiadzie pojawia się nowy głos. Student może ułożyć wykład, nagrywając linijka po linijce: gdzie mówił profesor i o co pytała publiczność. Edytor podcastów może zlokalizować fragmenty długiej sesji, w których wszyscy rozmawiali ze sobą, i wyciąć je. Sekretarz spotkania może sporządzić wersję roboczą protokołu z kodami czasowymi, bez konieczności wysyłania nagrania gdziekolwiek.
Kiedy potrzebujesz czegoś innego
Jeśli chcesz uzyskać zwykły tekst, a nie podział głosowy, otwórz audio i wideo → tekst. Pozostałe narzędzia tej sekcji znajdują się na stronie Audio na stronie, a pod nią znajduje się więcej bezpłatnych narzędzi lokalnych Inne narzędzia. Analiza odbywa się poprzez otwartą bibliotekę FluidAudio (licencja MIT): kod i modele znajdują się w Twojej przeglądarce, bez objazdów do innych serwerów.