Kula głosowa, która faktycznie kontroluje witrynę: architektura asystenta, a nie „mówiące FAQ”
Krótko o najważniejszym (BLUF)
Mówiący widget na stronie internetowej nie jest asystentem, ale zabawką: mówi, ale nic nie robi. Nasza kula głosowa naprawdę zarządza witryną. Wewnątrz znajdują się trzy warstwy architektury, trzy grabie, na które nadepnęliśmy, ekonomia dialogu i sposób na umieszczenie tej samej kuli na Twojej stronie internetowej.
Asystenci głosowi na stronach internetowych zwykle kończą na jeden z dwóch sposobów: albo jest to chatbot z dołączonym rozpoznawaniem mowy, albo jest to lektor z często zadawanymi pytaniami. Jesteśmy w środku NeuralSpace przeszedł od zadania odwrotnego - wydobyć głos główny sposób zarządzania interfejsem, a nie nadbudową nad tekstem. Poniżej analiza architektury i decyzje, które trzeba było podjąć.
Zadanie
Użytkownik otwiera złożoną stronę generowania − wideo, kino, muzyka — w przypadku wyboru modelu, załadowanie referencji, zapytania, parametrów. Nowicjusz jest zagubiony. Ludzie zamykają klasyczny onboarding (wycieczkę ze strzałkami) na drugim etapie. Chcieliśmy, żeby było to możliwe po prostu powiedzieć głosem: „Chcę ożywić to zdjęcie”, a sam asystent podkreślił żądany przycisk, wyjaśnił go i doprowadził do rezultatu.
Kluczowa różnica w stosunku do chatbota: orb widzi stan strony I działa na niązamiast odpowiadać tekstem „naciśnij gdzieś przycisk X”.
Architektura: trzy warstwy
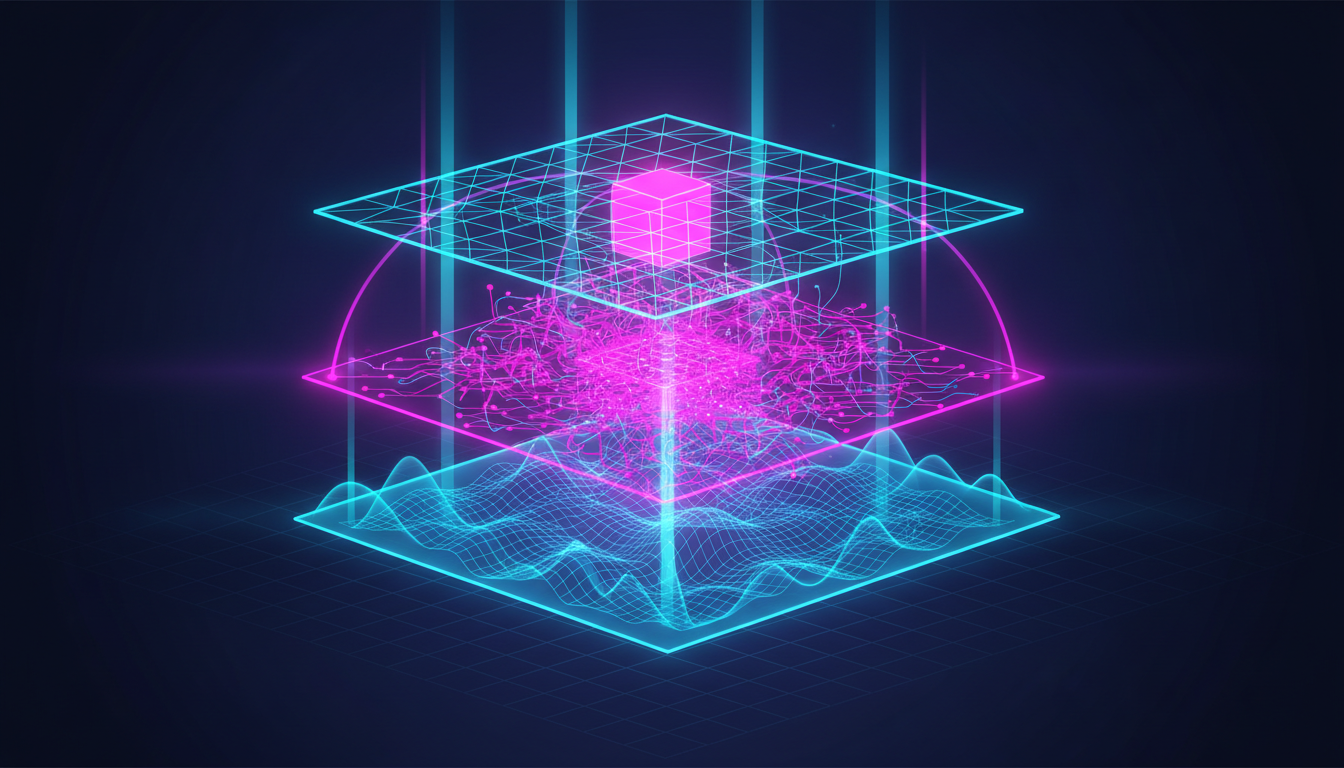
- Droga głosowa. Rozpoznawanie mowy strumieniowej → model → synteza odpowiedzi. Wymagane są małe opóźnienia i możliwości przerywać (wtargnięcie): użytkownik zaczyna mówić – asystent milknie. Bez tego dialog przypomina raczej walkie-talkie niż rozmowę.
- Mózg. Celowo oddzieliliśmy „osobowość” asystenta od konkretnego modelu językowego: model jest konfigurowany po stronie serwera, dzięki czemu można go zmieniać w zależności od zadania i kosztów bez konieczności przebudowy frontonu. Asystent otrzymuje nie tylko odpowiedź użytkownika, ale także czytelną maszynowo migawkę bieżącej strony: jakie elementy się tam znajdują, jakie przyciski, co jest już wybrane.
- Wykonawca na kliencie. Model zwraca nie tylko tekst, ale także działania: zaznacz element, przewiń do bloku, wyjaśnij pole. Klient wykonuje je na prawdziwym DOM-ie.
Nadepnęliśmy na trzy grabie
Najciekawszą rzeczą nie jest szczęśliwa ścieżka, ale porażki. Przeanalizowaliśmy logi prawdziwych dialogów i opracowaliśmy główne reguły.
1. Halucynacje możliwości. Asystent zasugerował modele, których nie było na bieżącej stronie lub pomylił model do zdjęć z modelem do wideo. Użytkownik jest słusznie zły: „nie ma takiego modelu”. Napraw - nie polegaj na „znajomości świata” modelki: asystent może nazywać i przełączać tylko to, co faktycznie znajduje się w migawce bieżącej strony. To klasyczny problem z uziemieniem - model musi być ściśle powiązany ze stanem interfejsu, w przeciwnym razie pewnie będzie kłamał.
2. Świeci się niewłaściwy przycisk. Proszą Cię o wyświetlenie „prześlij zdjęcie” - podświetlone jest „Generuj”. Powodem jest rozmyte mapowanie „intencja → element”. Rozwiązanie: elementy otrzymują kotwice semantyczne, a asystent musi je podświetlić dokładnie ten, o którym mówi, a nie sąsiadujące w znaczeniu.
3. Obsesja. Model został już wybrany – asystent nadal próbuje go zmienić; użytkownik pyta „po prostu napisz prośbę” - a on się kłóci. Zasada: jeśli stan jest już odpowiedni lub użytkownik wyraźnie prosi, aby nie dotykać - nie działaj i nie kłóć się, natychmiast wykonaj polecenie. Mniej inicjatywy, więcej wykonania.
Wniosek, jaki dalibyśmy każdemu, kto buduje agenta na bazie interfejsu, jest następujący: 90% jakości to nie wzór, ale fundament i dyscyplina działania. Model musi widzieć dokładny stan i nie może go przekraczać.
Ekonomia dialogu
Głos jest droższy niż tekst, więc Orb ma wolne okno, wtedy płatność odbywa się po rozmowie. Rozliczenia są powiązane z czasem trwania interakcji głosowej, a nie z liczbą „wiadomości”.
Ta sama kula znajduje się na Twojej stronie internetowej
Sami dostosowaliśmy kulę, ale zadanie jest uniwersalne: każda witryna z nietrywialnym interfejsem (konfigurator, konto osobiste, skomplikowany formularz, sklep z filtrami) korzysta z przewodnika głosowego, który widzi stronę i na niej działa. Dlatego umieściliśmy go w osadzonym widżecie - sposób jego instalacji i możliwości omówione są osobno: agent głosowy dla dowolnej witryny internetowej.
Jeśli robisz coś podobnego, interesujące jest porównanie podejść do uziemienia i wtargnięcia. Możesz spróbować na żywo na Orb neuronspace.pro.
Często zadawane pytania (FAQ)
Pytanie: Jak uzyskać najlepszy wynik z sieci neuronowej?
Odpowiedź: Używaj szczegółowych podpowiedzi (opisów) w języku angielskim, ustalaj styl i szczegóły sceny.
Pytanie: Czy te materiały można wykorzystać do celów komercyjnych?
Odpowiedź: Tak, wygenerowana treść jest całkowicie Twoja.