Gemini 4 Argon — już na stronie
W sieciach neuronowych pojawił się nowy model NeuralSpace - Gemini 4 Argon z Google. Jest już dostępny w pogawędzić, sekcja "Kod" i publiczne API. Oddzielna strona modelu - /chat/gemini-4-argon.
Co może Gemini 4 Argon
- Kontekst tokenów 1M. Można pobrać duży dokument lub prowadzić bardzo długą korespondencję – model utrzymuje wątek rozmowy od początku do końca.
- Rozumie nie tylko tekst. W żądaniu możesz pokazać zdjęcie, załączyć plik audio lub wideo – model przeanalizuje treść i na jej podstawie odpowie.
- Myśli zanim odpowie. Złożone problemy - matematyka, logika, plany wieloetapowe - model rozwiązuje się za pomocą rozumowania, a nie pierwszej odpowiedzi, która się pojawi.
- Narzędzia i wyszukiwarka internetowa. Podobnie jak sąsiednie modele na czacie: możesz poprosić modelkę o znalezienie odpowiednich informacji w Internecie.
- Kodowanie. Analizuje istniejący kod, planuje zmiany i wykonuje je krok po kroku, wyjaśniając wyniki.
Cena
Koszt naliczany jest na podstawie faktycznie wykorzystanych tokenów i odpisywany po otrzymaniu odpowiedzi – minimalny próg salda widoczny jest przed wysyłką, podobnie jak w przypadku pozostałych modeli w tym dziale. Aktualne ceny znajdują się na stronie API.
Jak spróbować
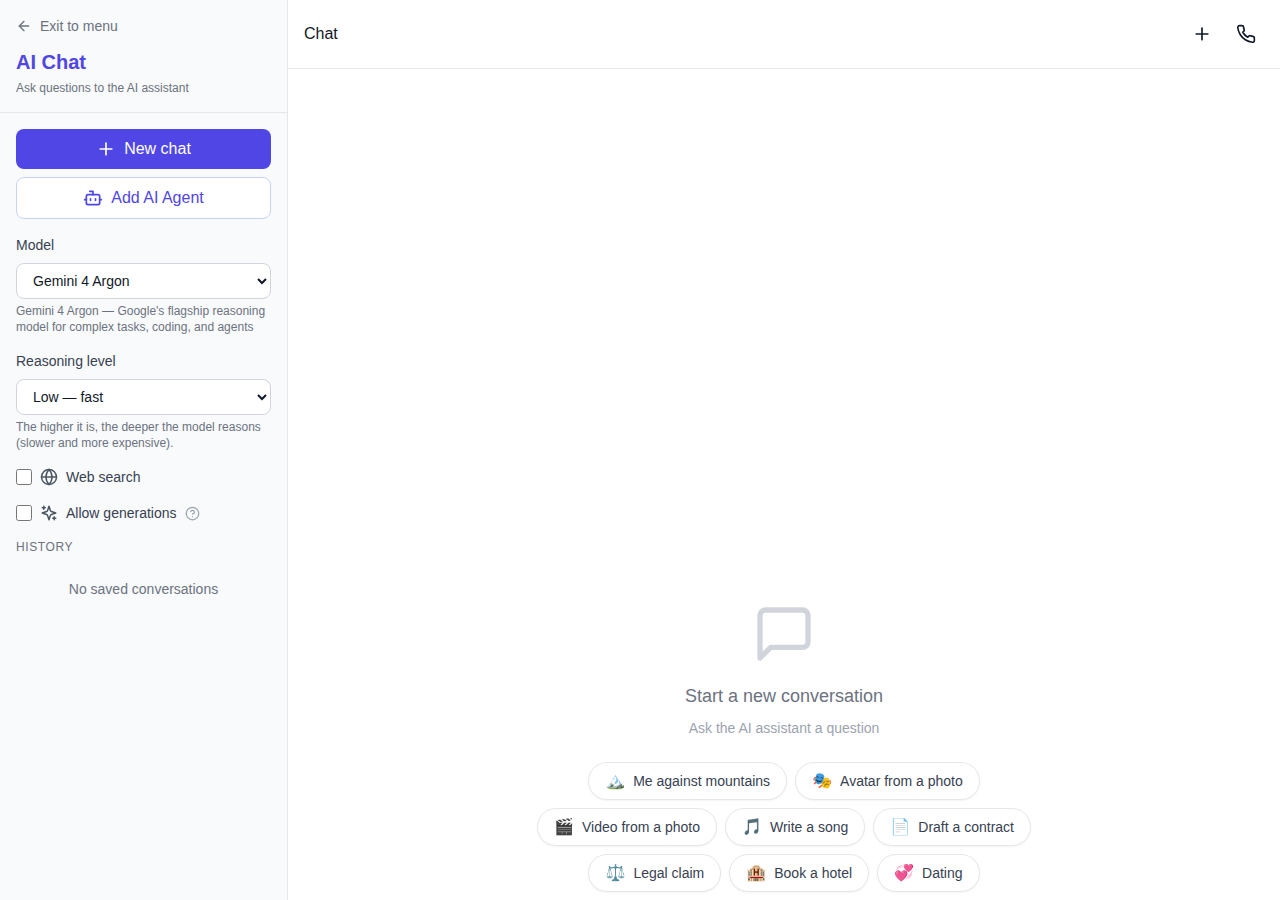
- Otwarte pogawędzić i wybierz z listy modeli Gemini 4 Argon — osobna strona poświęcona modelowi dostępna jest pod adresem /chat/gemini-4-argon.
- Zadaj pytanie jak zwykle: model odpowiada strumieniem i obsługuje wyszukiwanie w Internecie.
- W przypadku projektów otwórz sekcję "Kod" — tam model pełni rolę agenta: tworzy projekt, zapisuje i edytuje pliki oraz przeprowadza długie iteracje.
Co wiadomo o modelu: liczby Google i niezależne testy
Głównym źródłem danych są dane oficjalne karta modelu Gemini 4 Argon z Google DeepMind. Oto pomiary własne producenta: DeepSWE v1.1 – 77,9% (kodowanie agenta), AutomationBench – 51,3% (kompleksowe zadania biznesowe), CWE-bench v1 – 68% (autonomiczne usuwanie luk), LVBench – 91,7% (zrozumienie długiego wideo), Vals Index – 68,9%. Łączne okno wejścia i wyjścia to 1 milion tokenów, a gwarantowany limit na jedną odpowiedź to 64 tysiące (zgodnie z katalogiem OpenRouter); buforowanie żądań jest o 95% tańsze; cena początkowa - 2 $ za milion żetonów wejściowych i 10 $ za milion żetonów wyjściowych, po okresie wstępnym - 4 $/20 $.
Istnieją również niezależne pomiary. Laboratorium badawcze Vals AI wystawił model na własnym stoisku i potwierdził swoją pozycję lidera: pierwsze miejsce na 48 modeli w Vals Index (68,9% ± 0,97) i pierwsze miejsce na 78 w Finance Agent v2. Cena testu jest również orientacyjna: jedno uruchomienie kosztowało około 15,68 dolarów i trwało około 46 minut - model jest ciężki, ale skuteczny. Recenzja the-decoder.com bardziej powściągliwy: zdaniem autora Argon nadrabia dystans do OpenAI i Anthropic i w niektórych benchmarkach pokonuje konkurentów, ale nie obejmuje wyraźnego prowadzenia – Anthropic, według jego oceny, wciąż ma przewagę. Jednocześnie jak na flagowca model jest tani, szczególnie jak na cenę wywoławczą.
Konkluzja: liczby na karcie Google są oświadczeniem producenta; dotychczasowe niezależne testy potwierdzają je dla Vals Index i Finance Agent; w przypadku innych testów porównawczych nie przeprowadzono jeszcze testów stron trzecich. Szczegółową analizę ogłoszenia znajdziecie w naszym osobnym artykule. „Gemini 4 Argon: co wiadomo”. Na naszej stronie podajemy tylko to, co faktycznie tutaj działa: czat, „Kod”, API, wyszukiwarkę internetową i narzędzia.
Kiedy wybrać Argon
Argon to model do dużych zadań: długich dokumentów i korespondencji, analizowania plików i multimediów, złożonej matematyki i wieloetapowych skryptów agentów. Do szybkich codziennych odpowiedzi na czacie służą lekkie modele - na przykład Claude Haiku 5.5, a dla maksymalnej głębi rozumowania - starsze Claude Sonnet 5.5 i Claude Opus 5.5.