En stemmekule som faktisk kontrollerer nettstedet: arkitekturen til en assistent, ikke en "snakende FAQ"
Kort om det viktigste (BLUF)
En snakkende widget på et nettsted er ikke en assistent, men et leketøy: den snakker, men gjør ingenting. Vår stemmekule driver virkelig nettstedet. Inni er tre lag med arkitektur, tre raker som vi tråkket på, økonomien med dialog og en måte å sette den samme kulen på nettstedet ditt.
Taleassistenter på nettsteder ender vanligvis på en av to måter: enten er det en chatbot med talegjenkjenning tilknyttet, eller det er en FAQ-voiceover. Vi er medNeuralSpacegikk fra den omvendte oppgaven - å lage en stemmeden viktigste måten å administrere grensesnittet på, og ikke en overbygning over teksten. Nedenfor er en analyse av arkitekturen og beslutninger som måtte tas.
Oppgave
Brukeren åpner en kompleks generasjonsside −video, bilder, musikk— der det er et valg av modell, lasting av en referanse, en forespørsel, parametere. Nykommeren er tapt. Folk lukker den klassiske onboarding (tur med piler) på andre trinn. Vi ønsket at det skulle være mulig å enkeltsi med en stemme: "Jeg vil gjøre dette bildet levende," og assistenten selv fremhevet ønsket knapp, forklarte det og brakte det til resultatet.
Hovedforskjell fra en chatbot: orbser sidens tilstandOghandler på henne, i stedet for å svare med teksten "trykk på X-knappen et sted der."
Arkitektur: tre lag
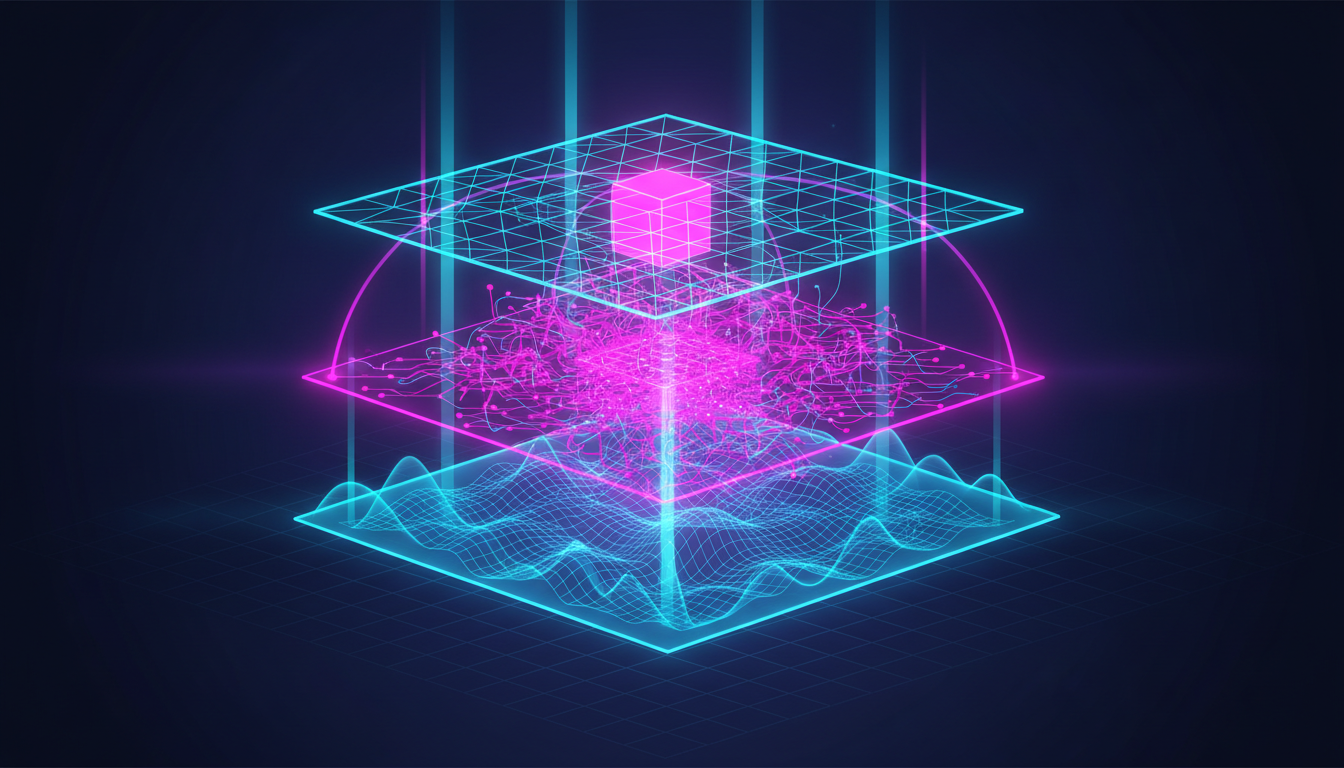
- Vokaltrakt.Streaming talegjenkjenning → modell → responssyntese. Kravet er lav latens og evneavbryte(barge-in): brukeren begynner å snakke - assistenten blir stille. Uten dette føles dialogen som en walkie-talkie snarere enn en samtale.
- Hjerne.Vi har bevisst koblet "personligheten" til assistenten fra en spesifikk språkmodell: Modellen er konfigurert på serversiden, slik at den kan endres for å passe oppgaven og kostnaden uten å re-utvikle grensesnittet. Assistenten mottar ikke bare brukerens svar, men ogsåmaskinlesbart øyeblikksbilde av gjeldende side: hvilke elementer er der, hvilke knapper, hva er allerede valgt.
- Utfører på klienten.Modellen returnerer ikke bare tekst, men ogsåhandlinger: marker element, bla til blokk, forklar felt. Klienten utfører dem på toppen av den virkelige DOM.
Tre raker tråkket vi på
Det mest interessante er ikke den lykkelige veien, men feilene. Vi analyserte loggene til ekte dialoger og kom opp med rotreglene.
1. Hallusinasjon av muligheter.Assistenten foreslo modeller som ikke var på den gjeldende siden, eller forvekslet modellen for bilder med modellen for video. Brukeren er med rette sint: "det er ingen slik modell." Fix - ikke stol på modellens "kunnskap om verden": assistenten kan navngi og byttebare det som faktisk er i øyeblikksbildet av gjeldende side. Dette er et klassisk jordingsproblem - modellen må være strengt knyttet til tilstanden til grensesnittet, ellers vil den trygt lyve.
2. Feil knapp lyser.De ber deg vise "last opp et bilde" - "Generer" er uthevet. Årsaken er den uklare "intensjon → element"-kartleggingen. Løsning: elementer mottar semantiske ankere, og assistenten må markereakkurat den, som han snakker om, og ikke nærliggende i betydningen.
3. Obsessivitet.Modellen er allerede valgt - assistenten prøver fortsatt å endre den; brukeren spør "bare skriv en forespørsel" - og han argumenterer. Regel: hvis tilstanden allerede er egnet eller brukeren eksplisitt ber om å ikke røre -ikke handle eller krangle, gjør umiddelbart det som blir bedt om. Mindre initiativ, mer gjennomføring.
Konklusjonen vi vil gi til alle som bygger en agent på toppen av et grensesnitt er:90% av kvalitet er ikke en modell, men forankring og disiplin av handling. Modellen må se den nøyaktige tilstanden og har ikke lov til å gå utover den.
Økonomi i dialog
Stemme er dyrere enn tekst, så Orb har et gratis vindu, deretter betales ved samtale. Fakturering er knyttet til varigheten av taleinteraksjonen, ikke antallet «meldinger».
Den samme kulen er på nettstedet ditt
Vi tilpasset kulen for oss selv, men oppgaven er universell: ethvert nettsted med et ikke-trivielt grensesnitt (konfigurator, personlig konto, kompleks form, butikk med filtre) drar nytte av en stemmeguide som ser siden og handler på den. Derfor legger vi den inn i en innebygd widget - hvordan den er installert og hva den kan gjøre diskuteres separat:taleagent for ethvert nettsted.
Hvis du gjør noe lignende, er det interessant å sammenligne tilnærmingene til grunnstøting og innkjøring. Du kan prøve orb live påneuralspace.pro.
Vanlige spørsmål (FAQ)
Spørsmål: Hvordan få det beste resultatet fra et nevralt nettverk?
Svar: Bruk detaljerte ledetekster (beskrivelser) på engelsk, angi stilen og detaljene for scenen.
Spørsmål: Kan disse materialene brukes til kommersielle formål?
Svar: Ja, det genererte innholdet er helt og holdent ditt.