Dybdekart for Seedance 2.5: hvordan omgå ansiktsblokkering
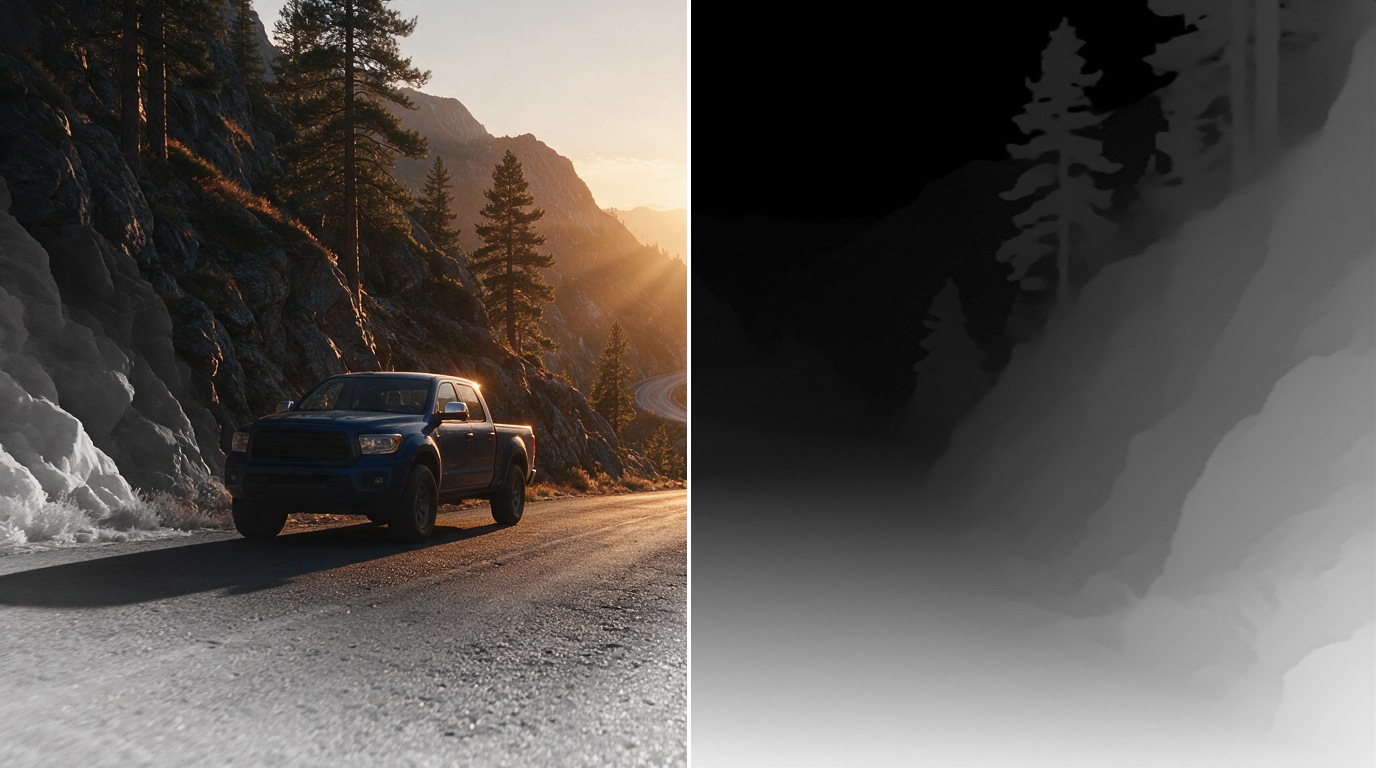
Seedance 2.5 nekter å jobbe hvis det er et gjenkjennelig ansikt eller en del av en annens film i rammen. Dette er hvordan selskapet kjemper mot forfalskninger av kjendiser, men det kommer til vanlige mennesker: noen ganger avviser en modell til og med din egen selfie. Det er en løsning, og det handler ikke om hacking. Modellen passerer enkelt gjennom dybdekartet – et sort/hvitt bilde der lysstyrken viser avstanden til kameraet. Det er ingen ansikter på den, bare geometrien til scenen. Nedenfor ser du hvordan du kan lage et slikt kart fra videoen din gratis, rett i nettleseren, og hva du skal gjøre hvis generasjonen fortsatt faller.
Hvorfor ser en modell en kjendis der det ikke er noen?
Filtre Seedance er trent på ansikter. Oppgaven deres er enkel: å forhindre at utseendet til en kjent person blir forfalsket. Problemet er at de definerer "berømmelse" ved ansiktets geometri, og ikke ved navnet i studiepoengene. En lignende øyeform, samme hakeform - og det er det, avslag.
Det er enda enklere med filmopptak: opphavsrettsbeskyttelse fungerer der. Modellen gjenkjenner scenen og savner den ikke helt, selv om du bare vil gjenta kamerabevegelsen.
Resultat: to forskjellige forbud, men det ser likt ut - en rød feil og bortkastet tid.
Dybdekart: geometri i stedet for ansikter
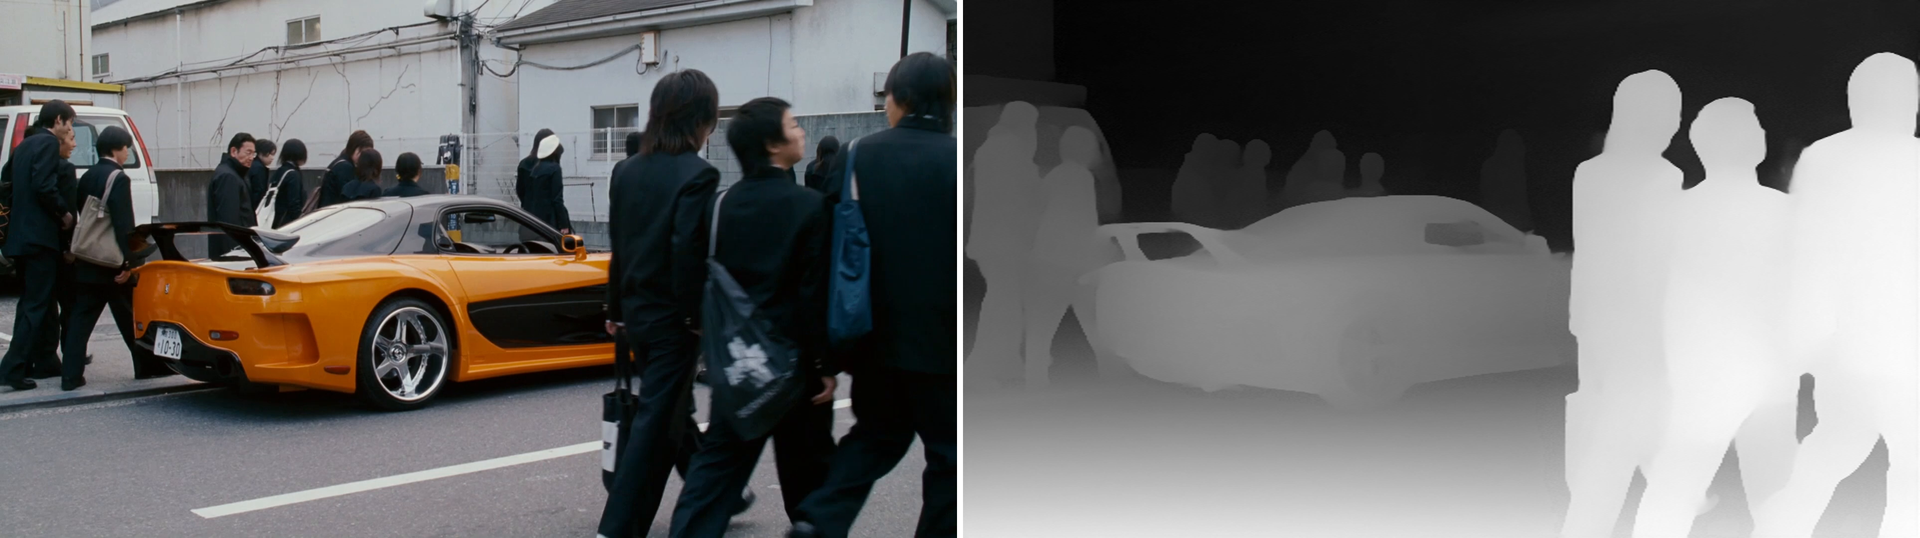
Et dybdekart er den samme videoen, kun tegnet på nytt i gråtoner. Jo nærmere objektet er kameraet, desto lysere blir pikselen. Bakgrunnen blekner til svart, bakgrunnen til hvit. Ingen teksturer, ingen hud, ingen øyne: alt som gjenstår er lettelsen av scenen.
Dette er et nøkkelpunkt for filteret. Det er ingenting å sjekke - det er ingen ansikter. Og for generasjon er det alt du trenger: hvor gjenstandene var, hvor kameraet skulle, hvordan planen endret seg. Vi kopierer ikke noen andres ramme, vi tar bevegelsen og arrangementet fra den, og modellen tegner sitt eget bilde, fra bunnen av.
Ærlig talt om begrensningen: det er ikke en "omgå alt-knapp." Hvis du umiddelbart spør direkte etter ansiktet til en spesifikk skuespiller, vil avslaget komme igjen. Dybdekartet løser problemet med geometri og bevegelse, ikke personlighetssubstitusjon.
Hvordan lage et dybdekart fra en video - gratis og uten opplasting til serveren
På vår nettside er dette en egen modell i videodelen: Dybdekart (gratis). Den er i listen over modeller under MiniMax. Du velger en video, trykker på en knapp, og alt beregnes på enheten din.
Hva er inne: modell Depth Anything V2 Small (lisens Apache 2.0) spiller direkte i nettleseren via ONNX Runtime Web. Hvis du har WebGPU, teller skjermkortet, hvis ikke, fungerer backupbanen på prosessoren. Rammene analyseres gjennom WebCodecs, og settes deretter sammen til video med den originale FPS og den maksimale oppløsningen som nettleseren din kan håndtere.
Utgangen er MP4 eller WebM - hva nettleseren støtter. Det er en forhåndsvisning av resultatet, en bryter "Nærmere - lysere / Nærmere - mørkere" og paletter: nyanser av grått, Inferno, Viridis. Behandlingsfremdriften er synlig ramme for ramme; lang behandling kan kanselleres.
To ting som betyr mest. For det første: filen går ingen steder - verken til vår server eller til noen andres, alt arbeid foregår på enheten. For det andre: tokens avskrives ikke for dette; det er ingen betalt API i denne modellen i det hele tatt. Modellvektene og motorfilene bufres i nettleseren, slik at siden starter opp raskere andre gang.
Hvor det vil være ubehagelig. Du trenger Chrome eller Edge - WebCodecs er ikke tilgjengelig overalt. En lang video på en prosessor regnes ikke som rask: et minutt med kildemateriale kan ta flere minutter. Og det er bedre å ikke kjøre 4K på en svak bærbar datamaskin - start med 720p, se resultatet, og øk deretter oppløsningen.
Karakterutvikling: to feil som dreper resultatet
Den andre teknikken fra samme video er riktig utvikling av karakteren. Dette er ett bilde der ansiktet og klærne vises separat. Det avhenger av hvordan det er satt sammen om ansiktet vil flyte i generasjonen eller forbli på plass.
Den første feilen: ansiktet og klærne er tegnet i forskjellige skalaer. Modellen forstår ikke at dette er én person, og begynner å fullføre proporsjonene selv. Feil to: skanningen er satt sammen av deler av forskjellige mennesker - så er utgangen et gjennomsnittlig fremmed ansikt, og filteret fungerer igjen.
Arbeidsalternativet er én skanning, én person, samme lys og vinkel på begge deler.
Hvis generasjonen fortsatt mislykkes med en feil om en gjenkjennelig person
Det hender at dybdekartet er på plass, skanningen er satt sammen riktig, men Seedance nekter fortsatt. Dette betyr at problemet er i et av bildene, og vi må finne det.
Metoden er enkel - metoden for eliminering. Du fjerner referansene en etter en og starter på nytt. Så snart generasjonen går, var det det siste fjernede bildet som var skyld i. Deretter bygger du den enten om eller erstatter den med et dybdekart.
I lang tid? Ja. Men uten å gjette: i tre eller fire løp kan du se den nøyaktige årsaken.
Og den andre teknikken fra samme video: et vanlig rutenett påføres det skyldige bildet - til og med firkanter over ansiktet. Filteret slutter å se hele ansiktet, men for generering forblir funksjonene lesbare. Rutenettet plasseres i en hvilken som helst editor, eller det nevrale nettverket blir ganske enkelt bedt om å "sette et firkantet rutenett på dette bildet."
Overfør kamerabevegelser fra hvilken som helst film
Den samme teknikken fungerer uten å erstatte ansiktet. Du tar en ramme fra en film, lager et dybdekart av den, gir den til modellen sammen med oppfordringen din – og du får scenen din med samme kamerabevegelse: samme tilnærming, samme sving, samme rytme.
Slik skytes trailere, parodier og reklamefilmer når det trengs en "filmisk" tur, men det er ikke noe budsjett for en kameramann med kran.
Hva er neste
Rekkefølgen er som følger: først dybdekartet - gratis i nettleseren, uten å laste ned en fil og uten å avskrive tokens. Så generasjonen selv - Seedance 2.5 på vår nettside, det er også en karakterutvikling og referanser.
Hvis noe ikke fungerer første gang, start med et kort klipp på 3-5 sekunder. Den viser både kamerabevegelser og ansiktsatferd, og tar mye mindre tid og tokens.