DeepSeek V4 Pro 0813 er et historisk vendepunkt
Kort om det viktigste (BLUF)
DeepSeek ga ut den endelige versjonen V4 Pro - revisjon 0813: oppdateringen kom automatisk via API, uten presentasjoner eller referanser. Vi ser på nøyaktig hva som har økt ved å bruke benchmarks, regner ærlig ut forskjellen med Claude og GPT og forklarer hvorfor prisen ikke har endret seg ennå.
I dag rullet DeepSeek ut den endelige versjonen V4 Pro - revisjon 0813. Ingen konferanser eller nedtellingstellere: nettopp oppdatert API. De som allerede har jobbet med `deepseek-v4-pro` fikk automatisk en ny modell uten å endre noe i koden. April-en var en forhåndsvisning, denne er GA, og forskjellen er først og fremst merkbar der modellen forventes ikke å svare i en chat, men å fungere sammenhengende.

I dag er dagen da koding på Opus-nivå ble virkelig tilgjengelig.Dette forslaget ville ha vært en markedsførers drøm om morgenen, og om kvelden ville det vært et faktum med referanser.
I NeuralSpace står modellen allerede:i chat, V "Kode"-delenog innAPI. Det er ingen "vente på at den skal rulle ut" - du åpner den og bruker den.
Hvilken modell
Teknisk sett er dette samme beist som i april: Blanding av eksperter med 1,6 billioner parametere, hvorav 49 milliarder er aktive på hvert trinn. Konteksten er en million tokens, og modellen er i stand til å produsere opptil 384 tusen tokens i ett svar. Til sammenligning: dette er omtrent tjue ganger mer enn de fleste modellene i nabofanene.
Modellen kan tenke i to moduser - å tenke og ikke-tenke, og reasoning_effort har nå tre nivåer: maks, høy, lav. I praksis betyr dette at et lite problem kan løses billig, og en kompleks kjede kan løses med maksimal omtanke, uten å endre modellen.
Benchmarks: hva har vokst
Kunstig analyse målte den endelige versjonen på nytt. Intelligence Index økte fra 43,7 til 45,3. Kodeindeks - fra 58,7 til 59,4. Men Agentic Index hoppet mest: fra 35,3 til 37,8. Dette er ikke et uhell – revisjon 0813 ble korrigert spesifikt for agentbaserte scenarier, der modellen ikke reagerer i én omgang, men går frem og tilbake: leser filer, kaller verktøy, ser på resultatet og retter seg selv.
Når det gjelder hastighet, er alt på nivået til forrige versjon: omtrent 76 tokens per sekund ved utgangen, det første tokenet kommer på omtrent halvannet til to sekunder. Det er raskt for en modell av denne størrelsen. Ærlig ulempe: modellen er snakkesalig. Ved AA-målinger spruter den ut halvannen til to ganger flere tokens enn markedsgjennomsnittet – tenk på at du for detaljert resonnement betaler med både ekstra tokens og ekstra sekunders venting.
Mot Claude og GPT: rettferdig aritmetikk
Det mest merkbare i den siste tabellen er linjen med Claude Opus 4.8, Anthropics tidligere flaggskip. DeepSeek V4 Pro 0813 slo den i kodingsreferanser på begge sider: Terminal-Bench 2.1 - 87.9 mot 85.0, DeepSWE - 62.7 mot 58.0. Samtidig koster Opus 4.8 $5 per million input tokens og $25 per million output tokens - 11 og 29 ganger dyrere. Her er tabellen:
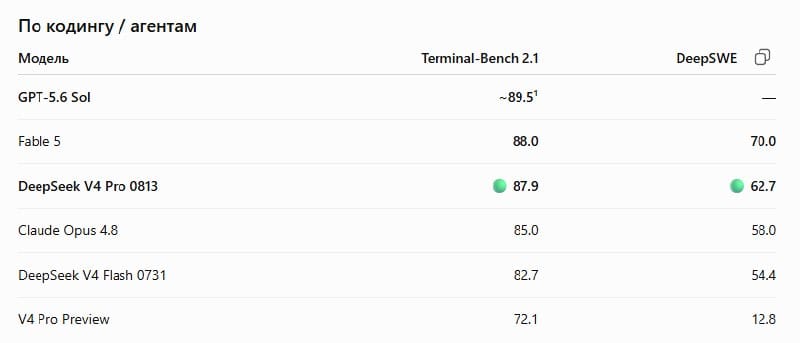
Den endelige versjonen kom nærmest Claude Fable 5: 87,9 mot 88,0 i Terminal-Bench - en tiendedel forskjell. Ifølge DeepSWE er Fable mer merkbart foran: 70,0 mot 62,7. Hvis du teller alle de ti agentbaserte benchmarkene fra tabellen DeepSeek, ligger Fable foran med et gjennomsnitt på 5,3 % – men på to av ti DeepSeek-seiere, og uten den eneste uteliggeren (Humanity's Last Exam uten verktøy: 42,7 vs 53,3) krymper den gjennomsnittlige ledelsen til 2,8 %.
Prisen varierer ikke med prosent, men flere ganger. Fabel 5 koster $10 per million input og $50 per million output tokens; V4 Pro har $0,435 og $0,87. Med en blandet hastighet fungerer det til rundt $30 mot $0,65. Det vil si at for en forskjell på noen få prosent i tester, ber Anthropic om å betale cirka 46 ganger mer. Forbehold om ærlighet: Jeg målte selv sammenligningstabellen DeepSeek, på min egen upubliserte infrastruktur, to av ti tester er interne, og det er ingen uavhengige målinger av 0813 ennå - modellen ble utgitt først i dag.
For å forstå skalaen, tenk på Kimi K3. For en måned siden var hun den første kinesiske modellen som gikk forbi Claude Opus – det var en sensasjon. Men Kimi K3 er en modell med billioner av parametere, den krever en dyr server for å kjøre, så i detaljhandelen er den bare tre ganger billigere enn Claude Fable og bare 40 % billigere enn Claude Opus. Imponerende, men det er ingen demokratisering i dette.
Men DeepSeek V4 Pro er et virkelig historisk øyeblikk. Å ta igjen Opus når det gjelder koding, koster 30 ganger mindre enn Opus og 60 ganger mindre enn Fable. I dag har vibecoding blitt tilgjengelig for alle – ikke i reklameforstanden «tilgjengelig», men til prisen for å komme inn i den.
Med GPT er situasjonen mer komplisert. GPT-5.5 scorer 56,3 i Artificial Analysis-indeksen mot 45,3 for DeepSeek - gapet er ærlig talt merkbart. Men tariffene er ikke sammenlignbare: $5/$30 per million mot $0,435/$0,87. Men den billigere GPT-5.6 Luna koster allerede $0,10/$0,60 - det vil si billigere enn DeepSeek - og får 52,3. Det viser seg at den "billigste av de store" ikke lenger er den eneste: til en pris på V4 Pro konkurrerer den med Luna, og poengmessig taper den til både Terra og Sol.
Jeg vil legge til et nøkternt sitat fra utsiden: en nylig vurdering av amerikanske NIST (CAISI) sa at V4 Pro ligger etter markedsledere med omtrent åtte måneder. Riktignok målte de en forhåndsversjon. Hvorvidt 0813 har redusert dette gapet vil bli vist av uavhengige benchmarks, men de eksisterer ikke ennå.
Prisen har ikke endret seg. Ha det
Inngang – $0,435 per million tokens, utgang – $0,87. Cash hit er fortsatt nesten gratis: $0,003625 per million, 120 ganger billigere enn vanlig inngang. For agentkjeder er dette hovedpoenget: prosjektkonteksten leses igjen og igjen, og det er cachen som bestemmer hvor mye en time agentarbeid koster.
En advarsel: DeepSeek har allerede advart i dokumentasjonen om at de kommer til å øke prisene for API-en som helhet. Når og hvor lenge er ikke sagt. April-takstene er fortsatt gjeldende, og dette er merkbart lavere enn vestlige analoger av en sammenlignbar klasse.
Hvor du kan prøve det akkurat nå
- Chat:åpnemodellside— den siste 0813 er allerede standard.
- Kode: V "Kode"-delenmodellen kobles til prosjektet og fungerer med depot, filer og terminal.
- API:nøkkelen utstedes i seksjonenAPI-nøkler NeuralSpace, format kompatibelt med OpenAI.
Betaling - i rubler fra den generelle saldoen, uten abonnement, VPN eller utenlandsk kort. Faktisk bruk avskrives, ikke pakken "måned i forveien".
Det modellen ikke kan gjøre er å se på bilder: input er kun tekst. Hvis du trenger analyse av et skjermbilde eller bilde, er dette for andre modeller. Men for tekst, kode og lange agentoppgaver er den endelige V4 Pro nå et av de mest ærlige forslagene når det gjelder kraft og prisforhold.Du kan sjekke det i chatten, og hvis du trenger å bygge det inn i produktet ditt -nøkkelen er hentet fra API-nøkler-siden.
Vanlige spørsmål (FAQ)
Spørsmål: Hvordan komme i gang?Svar: Registrer deg på plattformen og motta gratis tokens for testing.
Spørsmål: Er de genererte materialene egnet for kommersiell bruk?Svar: Ja, du får fulle kommersielle rettigheter til alt innhold som lages.