Proefgelezen vertaling: nasynchronisatie en ondertiteling corrigeren
Vertaling proeflezen - sectietool "Video-avatars", waarmee u de video vertaalt en waarmee u de vertaling kunt controleren voordat u de nasynchronisatie in elkaar zet: u ontvangt ondertitels in een bestand, bewerkt namen, termen en bewoordingen en begint pas dan met de laatste stemacteurs. Tussen de automatische vertaling en de voltooide video verschijnt een controlepunt: diezelfde ‘lees met je ogen’-stap die ontbreekt in een reguliere vertaling. Hieronder leest u wat deze tool is, wie hem nodig heeft, hoe u stap voor stap de hele cyclus doorloopt en hoe de prijs wordt berekend.
Wat is het en wie zal het nuttig vinden?
Reguliere videovertalingen werken volgens het “stel het in en vergeet het”-principe: u selecteert een taal, u krijgt een video met nasynchronisatie. Proeflezen vertaling werkt anders: de tool vertaalt eerst de video en geeft u de ondertitels voor proeflezen, en start de eindmontage pas nadat u het gecorrigeerde bestand heeft geüpload. De cyclus wordt een stap langer, maar deze stap is de enige die op betrouwbare wijze fouten in namen, titels, termen en grappen opmerkt, waar automatisering het vaakst struikelt.
Wie heeft het nodig: interviews en podcasts, lezingen en cursussen, bedrijfspresentaties en trainingsvideo's, recensies en advertenties, felicitaties van een avatar - alles wat wordt vertaald voor een live publiek. Vooral als er merken, afkortingen, vakjargon of woordspelingen in het frame voorkomen.
De mate waarin video een populair formaat op het platform is, blijkt uit de log: in 30 dagen (04-09-04-10-2026) werden 12.689 generaties gelanceerd, waarvan 2.334 video's het op een na grootste formaat zijn, na afbeeldingen (9.907) en tracks (448); eenheden van de gevechtsbasis, bron - server/seo/benchmarkData.json. Hoe meer video's kijkers in verschillende talen bereiken, hoe vaker ze geen 'vertaalvinkje' nodig hebben, maar vertrouwen in elk woord.
Waarom automatische vertaling verkeerd is
Machinevertalingen zijn er lange tijd goed in geslaagd de algemene betekenis vast te houden, maar schieten nog steeds tekort als het gaat om de details. Eigennamen, bedrijfs- en productnamen, afkortingen, meeteenheden, straattaal en woordspelingen worden allemaal regelmatig willekeurige woorden. Een typisch voorbeeld uit onze praktijk van het vertalen van inhoud: 'Boerderij' in een titel over een bekende wiskundige stelling veranderde vol vertrouwen in een 'boerderij' - een boerderij - en de betekenis ging in alle talen tegelijk verloren. Bij het nasynchroniseren komt een dergelijke fout van de lippen van de spreker en wordt onmiddellijk opgemerkt: de kijker hoort een onjuiste naam waar hij nauwkeurigheid verwachtte.
Er is een tweede risico: inconsistentie. Een machine kan dezelfde term aan het begin en aan het einde van een video anders vertalen, en in een reeks video's - in elke aflevering anders. Voor de kijker ziet het er slordig uit, voor deskundige content oogt het onprofessioneel. Nog geen enkele automatische fase geeft 100%: volgens platformstatistieken van 90 dagen (07/06–10/04/2026) bedraagt het aandeel succesvolle voltooiingen voor volwassen modellen 79,7–92,2% (Kling 3,0 - 298 uit 374, Seedream 4,5 - 1.036 uit 1.127, GPT Image 2 - 3.244 uit 3 518; bron - server/seo/benchmarkData.json). De vertaalfout is milder dan een generatiefout: de video wordt vrijgegeven, maar de tekst klopt niet. Als het resultaat dus naar de mensen gaat, loont het controleren voordat de eindmontage plaatsvindt.
Hoe het werkt: drie stappen
De hele cyclus valt in drie stappen.
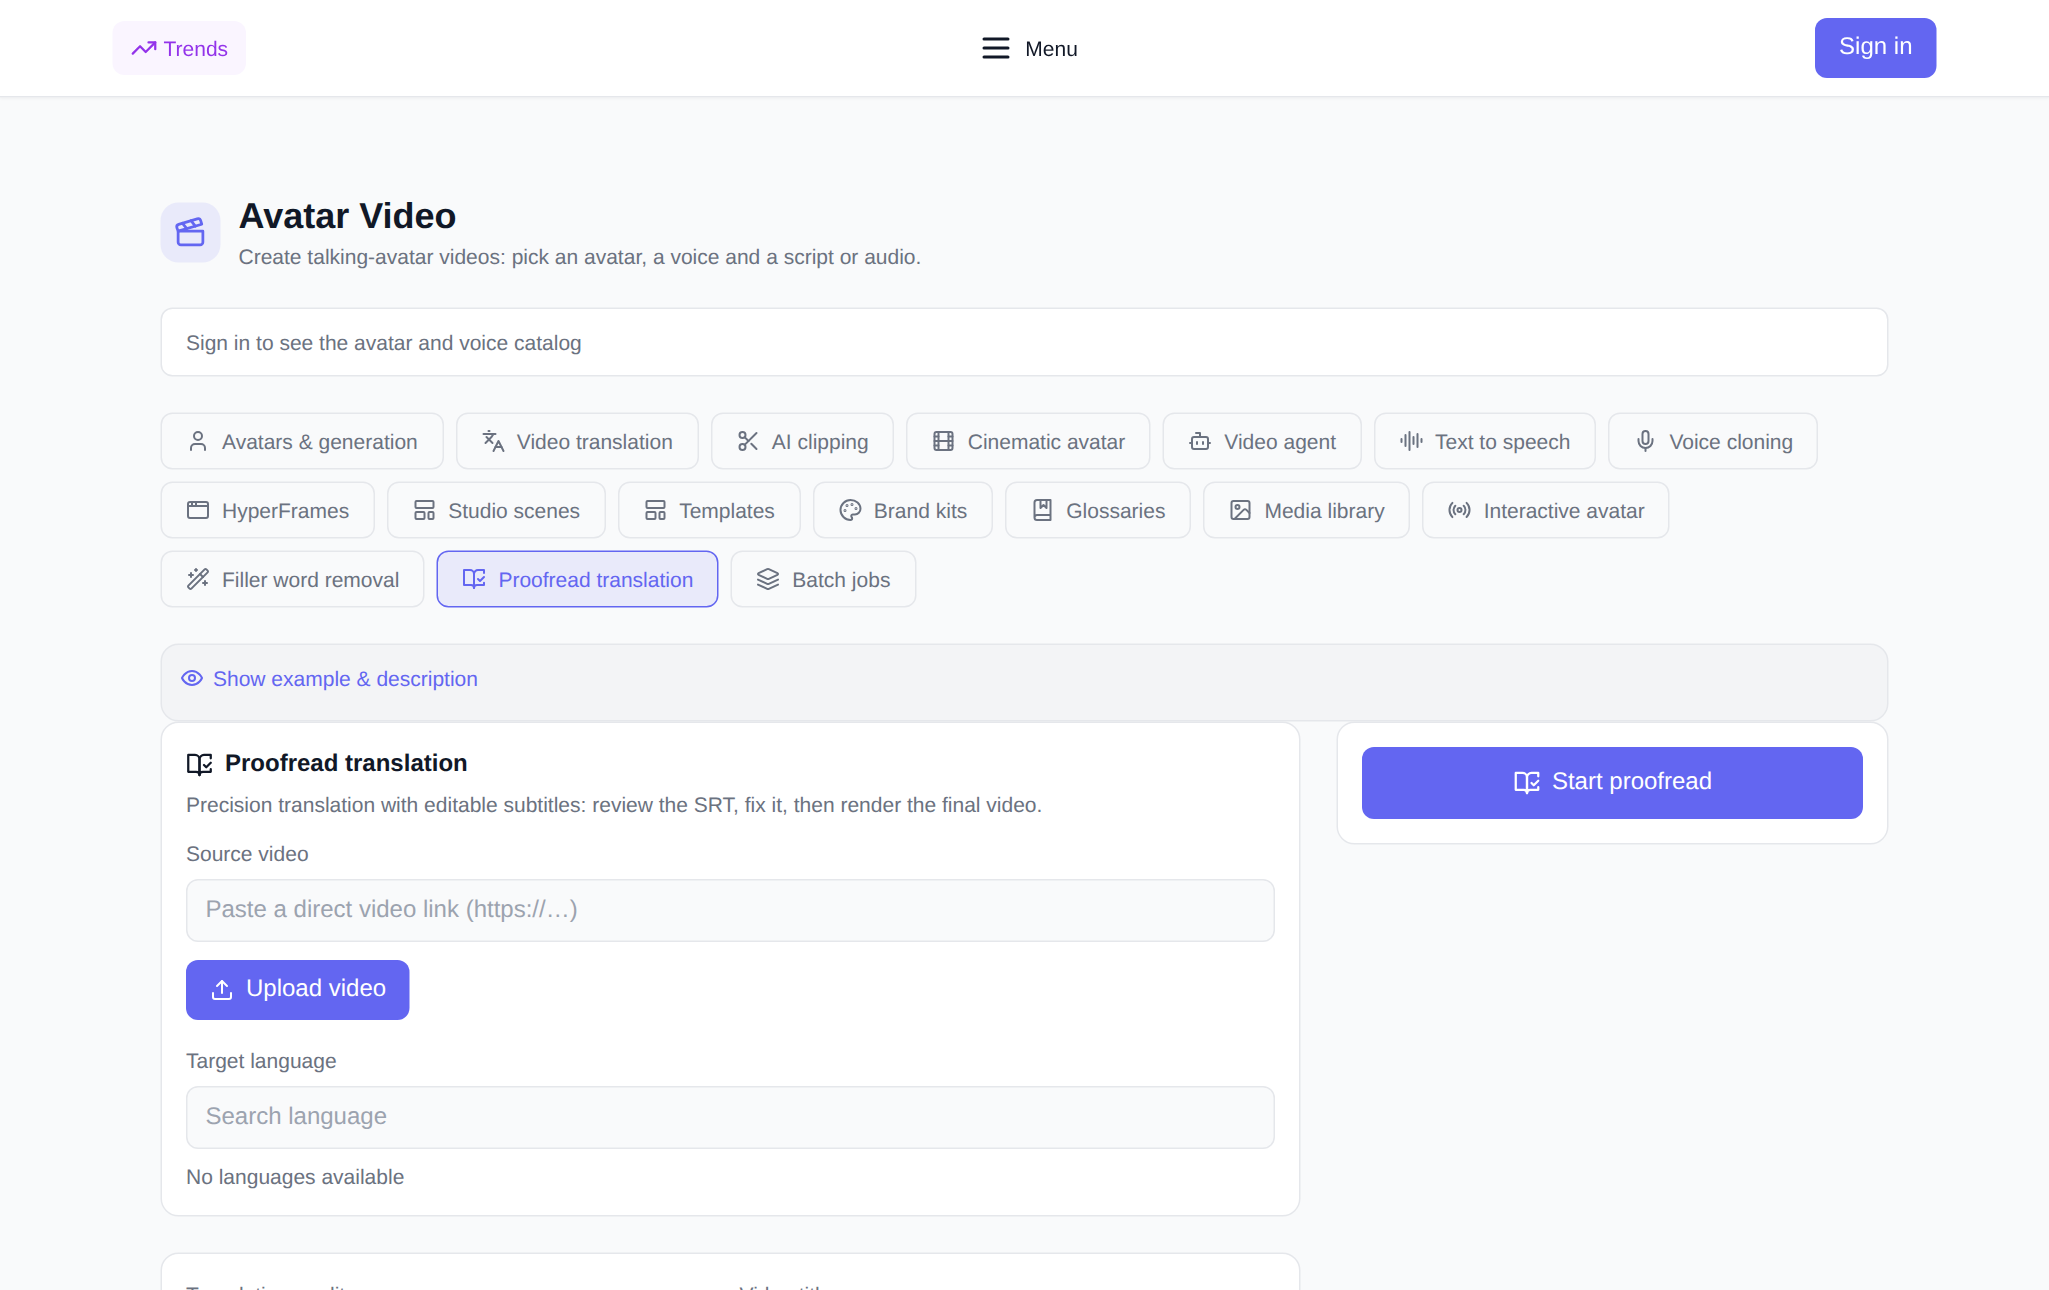
- Start een sessie. Open het tabblad "Proeflezen vertaling", voeg een video toe - upload een bestand of plak een directe link - selecteer de vertaaltaal en kwaliteitsmodus: "Nauwkeurigheid" (hogere lipsynchronisatiekwaliteit) of "Snelheid" (sneller). Stel desgewenst de taaknaam in en maak verbinding glossariumzodat termen en namen op een vooraf gedefinieerde manier worden vertaald. De prijs is vóór de lancering zichtbaar: deze wordt berekend op basis van de duur van de bron, die de server zelf meet.
- Corrigeer de ondertitels. Wanneer een sessie klaar is, verschijnt de knop ‘Download SRT’ op de kaart: dit is een tekstbestand met replica’s en tijdstempels. Corrigeer de namen, termen en bewoordingen in een willekeurige teksteditor, upload het bestand naar een openbare plaats (cloud, bestandsopslag) en plak een link ernaar in het veld "Openbare link naar de gecorrigeerde SRT" en klik vervolgens op "SRT uploaden".
- Verzamel de laatste video. Naast de knop "Verzamel laatste video" wordt de prijs van deze bewerking weergegeven - deze is zichtbaar voordat u erop klikt. De weergave vindt op de achtergrond plaats, de status wordt op dezelfde kaart weergegeven en het resultaat - de voltooide video - kan vanaf daar worden gedownload.
Handig detail: het herstarten van de assembly is beschermd tegen onbedoelde duplicaten. Nadat de weergave is gestart, verdwijnt de knop. Als u nogmaals klikt, wordt er geen tweede betaling gegenereerd, en als de weergave mislukt, wordt deze eerlijk gemarkeerd met een fout en kan de lancering worden herhaald.
Wat haal je eruit?
Er zijn twee resultaten voortgekomen uit de proefgelezen vertaalsessie. De eerste zijn ondertitels: een SRT-bestand met vertaling, dat zelfs zonder de eindmontage bij je blijft. De tweede is de uiteindelijke video: nasynchronisatie en lipsynchronisatie worden samengesteld op basis van uw proefgelezen tekst, en niet op basis van de eerste versie van de vertaling. Alles blijft in de geschiedenis: sessie- en renderstatussen, prijs-, download- en verwijderknoppen. Als er iets mislukt, worden de betaalde tokens automatisch teruggegeven - zowel voor de mislukte vertaalsessie als voor de mislukte eindmontage.
Wat is de prijs
Er is geen abonnement: nieuwe gebruikers krijgen starttokens voor hun eerste tests, daarna betaal je voor elke taak met tokens. Bij een proefgelezen vertaling zijn er twee betaalde handelingen (voorbereiding van de vertaling met ondertitels en eindmontage) en elke bewerking wordt geteld op basis van de duur van de bronvideo. Beide prijzen worden vóór de lancering getoond en het getoonde bedrag is gelijk aan de afschrijving: de server meet het bestand zelf, het is niet nodig om handmatig iets te tellen.
Waar mee te combineren
- Videovertaling — wanneer u zo snel mogelijk wilt kopiëren zonder handmatig bewerken.
- Woordenlijsten — zodat de termen onmiddellijk, vóór het proeflezen, worden vertaald.
- Voice-over van de tekst — stem synthetiseren als video niet nodig is, maar alleen geluid.
- Avatars en generatie - neem een sprekende avatar helemaal opnieuw op.
Veelgestelde vragen
Waarin verschilt een proefgelezen vertaling van een reguliere videovertaling?
De gebruikelijke vertaling geeft de video onmiddellijk met nasynchronisatie. Proofread toont eerst de ondertitels: u bewerkt de tekst, uploadt het gecorrigeerde bestand en voert dan pas de build uit. In het tweede geval wordt een onjuiste naam of term vóór de voice-over gecorrigeerd en is deze niet te horen in de voltooide video.
Wil je weten hoe je met ondertiteling moet werken?
Nee. SRT is een eenvoudig tekstbestand met replica's en tijdstempels; het kan door elke teksteditor worden bewerkt. Het is voldoende om de tekst te vervangen en het bestand op te slaan.
In welke talen kan de video worden vertaald?
De lijst is groot: ongeveer 190 talen met zoeken op naam, van Engels en Arabisch tot Japans en Hindi. De taal wordt voor elke taak afzonderlijk geselecteerd.
Wat gebeurt er als de taak mislukt?
Tokens worden automatisch geretourneerd: zowel voor een mislukte vertaalsessie als voor een mislukte montage. Een mislukte taak kan uit de geschiedenis worden verwijderd.