성우 Gemini TTS: 30개 음성 및 모든 설정
섹션에서 "오디오" 새로운 도구가 나타났습니다 - 대화 성우 Gemini TTS. 완성된 스크립트를 사운드로 변환합니다. 화자, 음성 및 캐릭터를 지정하면 서비스에서 대사를 하나씩 음성으로 말하고 완성된 MP3을 반환합니다.
이건 무슨 악기인가요?
이것은 하나의 텍스트를 한 목소리로 읽는 것이 아니라 전체 내용을 읽는 것입니다. 다중 화자 대화. 각 캐릭터는 자신만의 목소리, 악센트, 프레젠테이션 스타일 및 템포를 가지며 대사는 발표자 간의 대화, 촌극, 인터뷰, 비디오 캐릭터의 대사 등 의도한 대로 들립니다.
사용 가능한 두 가지 모델:
- Gemini 3.8 Flash TTS — 표현력이 뛰어난 성우 연기: 풍부한 감정, 더욱 자연스러운 리듬, 더욱 섬세한 전달 제어. 팟캐스트, 오디오북, 음성 해설에 적합합니다.
- Gemini 3.8 Flash-Lite TTS — 동일한 메커니즘이 더 저렴하고 빠릅니다. 대용량, 초안 및 텍스트를 소리내어 읽는 경우입니다.
어떤 설정을 사용할 수 있나요?
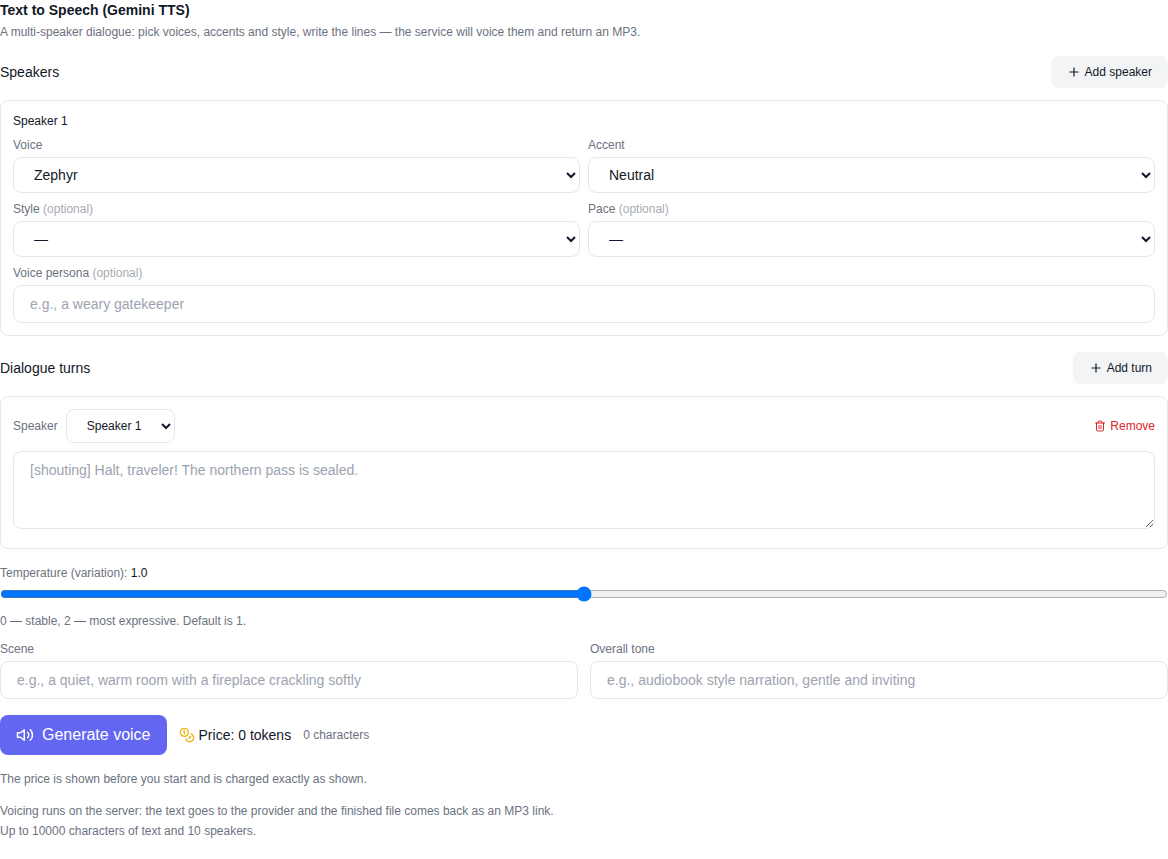
인터페이스에는 성우 모델이 제공하는 모든 매개변수가 표시됩니다.
- 화자. 하나에서 여러 문자까지; 각각에는 "Speaker 1", "Speaker 2" 등의 고유한 서명이 있으며 이를 통해 복제본이 음성과 연결됩니다.
- 30표 - 부드러운 서사부터 에너제틱한 '뉴스'까지.
- 8개의 액센트 - 중립, 미국(일반, "계곡", 남부), 영국(RP 및 브릭스턴), 대서양 횡단, 호주.
- 6가지 서빙 스타일 — 목소리의 미소, 아나운서, 속삭임, 공감, 홍보 및 "건조한" 고른 톤.
- 4가지 말하기 속도 - 자연스럽고, 두둑하고, 부드러운 "드리프트" 및 육포.
- 음성 캐릭터 - '따뜻한 이야기꾼', '엄격한 문지기' 등 자유로운 설명이 가능합니다.
- 온도 - 0에서 2까지: 낮음 - 더욱 안정적이고 예측 가능하며, 높음 - 더욱 생생하고 다양합니다.
- 장면과 일반적인 톤 - 설정에 대한 설명(“탁탁거리는 벽난로가 있는 조용한 방”) 및 내레이션 스타일(“부드럽고 매력적인 오디오북”).
- 복제본 — 각 대화 줄은 최대 10,000자입니다. 복제본의 순서는 유지됩니다.
대화를 음성으로 표현하는 방법: 단계별
- 열려 있는 '오디오' 섹션 모델을 선택하고 Gemini 3.8 Flash TTS 또는 Flash-LiteTTS - 모델 목록 하단에 있습니다.
- 화자를 추가하고 각 사람의 목소리, 억양, 스타일, 템포를 맞춤설정하세요.
- 대화의 대사를 쓰고 각각의 화자를 식별하십시오.
- 원하는 경우 장면 설명, 전반적인 톤, 온도를 입력합니다.
- 가격을 살펴보세요. 출시 전에 표시되며 텍스트를 입력하면 다시 계산됩니다.
- '음성'을 클릭하고 준비가 되면 결과를 듣고 다운로드하세요 MP3.
비용은 얼마입니까?
가격은 실제 텍스트 양을 기준으로 계산됩니다. 복제본이 길수록 비용이 높아지며 출시 전에 확인할 수 있습니다. 생성 후에도 놀랄 일이 없습니다. 결제는 다른 유료 세대와 마찬가지로 사이트 토큰을 사용하여 이루어집니다. 실패하면 토큰이 자동으로 반환됩니다. 가격 안내는 양식에서 직접 볼 수 있습니다. 스크립트를 입력하는 동안 금액이 업데이트됩니다.
자주 묻는 질문
두 명 이상의 캐릭터 간의 대화에 음성 해설을 추가할 수 있나요? 예, 각 화자에는 고유한 음성과 설정이 있으며 대사는 교대로 진행됩니다.
결과는 어떤 형식으로 나오나요? MP3 - 페이지에서 듣고 버튼 하나로 다운로드할 수 있습니다.
모델은 어떤 언어를 사용합니까? 이 모델은 다국어를 지원합니다. 러시아어와 영어를 포함한 수십 가지 언어로 텍스트를 음성으로 출력합니다.
무엇을 선택할 것인가: 플래시 또는 Flash-Lite? 표현력이 풍부한 프로젝트의 경우 - 플래시, 대용량 및 초안의 경우 - Flash-Lite: 메커니즘은 동일하지만 더 저렴하고 빠릅니다.
시도하려면 비용을 지불해야 합니까? 상각은 성우 시작 시 발생하며, 오류가 있을 경우 토큰이 자동으로 반환됩니다.