Seedance 2.0 に日本語を話させる方法: 2 つのやり方
Seedance 2.0 は、テキスト プロンプトと画像を対話付きのビデオに変換します。非ラテン語アルファベットで書かれた行は、必ずしも明確に発音されるとは限りません。希望のセリフを取得する方法と、そのシーンを自分の声で鳴らす方法が 2 つあります。
方法 1: 行をラテン文字で書く
非ラテン語アルファベットで書かれた行は、必ずしも明確に発音されるとは限りません。単語をラテン文字で綴り、厳密な音訳規則ではなく、その発音通りに書きます。これにより、必要な音がモデルに伝わります。
これは最も速いオプションです。追加のツールは必要なく、プロンプト内のテキストを編集して生成を実行するだけです。
方法 2: 事前に音声を作成する
音声ジェネレーターで必要なラインを合成し、完成したオーディオを Seedance 2.0 にアップロードしてプロンプト内で参照します。モデルはテキストや画像とともにオーディオを受け入れ、シーンを自分の声で音声化します。
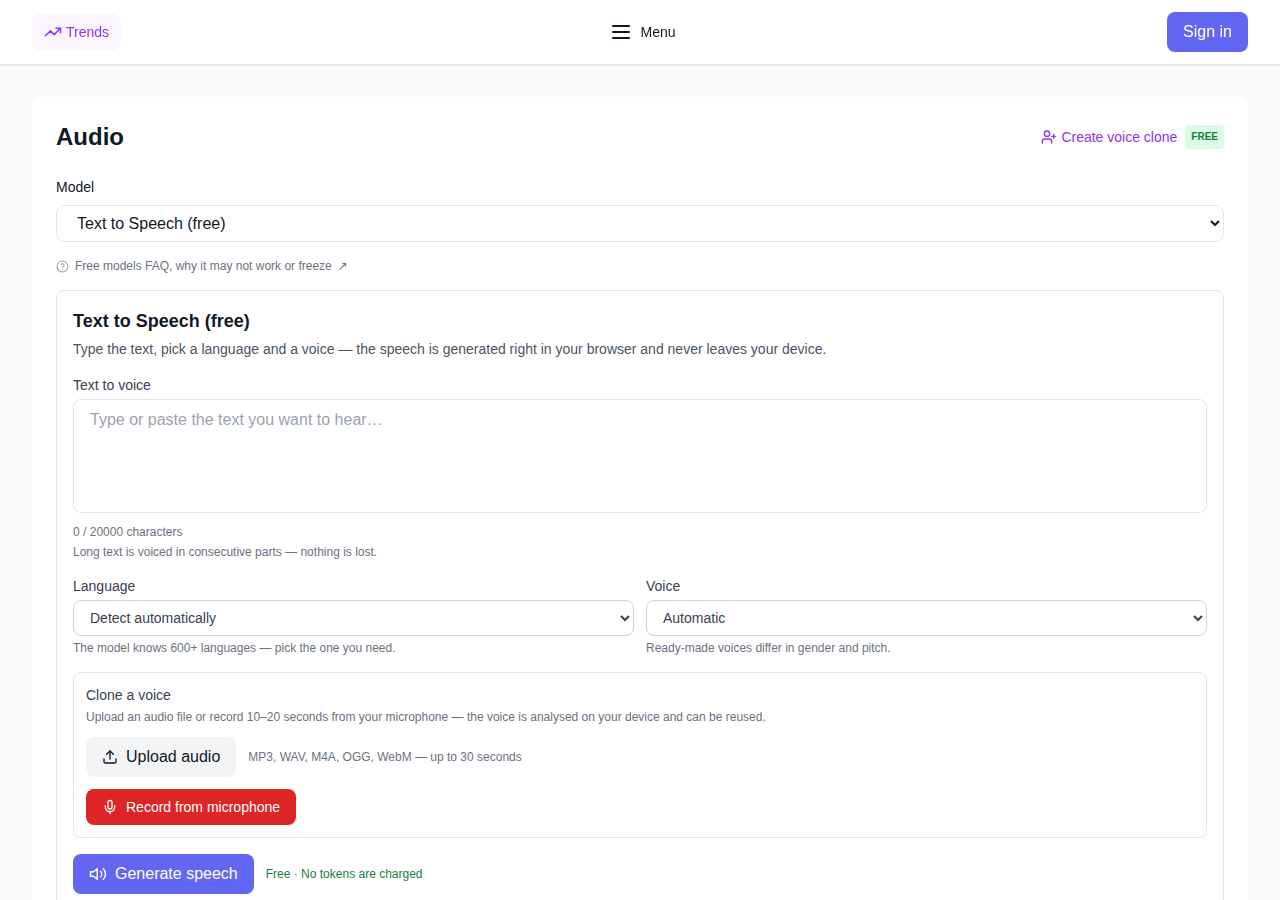
ブラウザ ツール テキスト読み上げ(無料) を使用すると、独自の音声を無料で生成できます。ブラウザ内で直接実行され、トークンの請求はなく、テキストがデバイスから送信されることはありません。
ポーズや特定のイントネーションが必要な場合は、安価です。イントネーション付きのテキスト読み上げ ツールはポーズやアクセントを追加します。価格はテキスト サイズによって異なり、開始前に表示されます。
シーンを自分の声で表現する方法
自分の声をそのままビデオに入れる方法は 2 つあります。
自分自身を録音し、音声をアップロードします。電話またはマイクでセリフを録音し、プロンプトとともに音声ファイルを Seedance 2.0 にアップロードします。モデルは音声を入力として受け入れ、それを中心にシーンを構築します。
まず音声を生成し、それを保持します。無料のブラウザ ツール テキスト読み上げ(無料) では、アップロードされたファイルまたはマイクからの短い録音 (10 ~ 20 秒で十分) から自分の声のクローンを作成し、セリフを音声化して結果をダウンロードできます。そのファイルを Seedance 2.0 にアップロードします。すべてのテイクを録音しなくても、シーンは自分の声で聞こえます。
正直なヒントをいくつか。雑音のない、短くクリーンな録音を心がけてください。最初に短いクリップで結果を確認してください。音声はセリフと同じ言語にしてください。
どれを選ぶか
- ラテン文字 — 速くてシンプル: 下書きや日常の短いセリフに適しています。
- 既成の声 — より正確な音声とイントネーション: ビデオ内の重要な会話に。
よくある質問
自分の声をSeedanceにアップロードできますか? はい: 音声ジェネレーターでラインを生成し、プロンプトとともに音声ファイルを Seedance 2.0 にアップロードします。モデルは音声を入力として受け入れます。
音声生成は有料ですか? いいえ、基本的なブラウザー音声ツールは無料で、トークンも請求されません。有料オプションは、ポーズとイントネーションを含む音声です。価格は開始前に表示されます。
どちらの方法がより信頼できるでしょうか? 準備ができたオーディオ録音: 音声とイントネーションは作成したものとまったく同じです。モデルは推測するのではなく、再現します。