Mappa di profondità per Seedance 2.5: come aggirare il blocco del volto
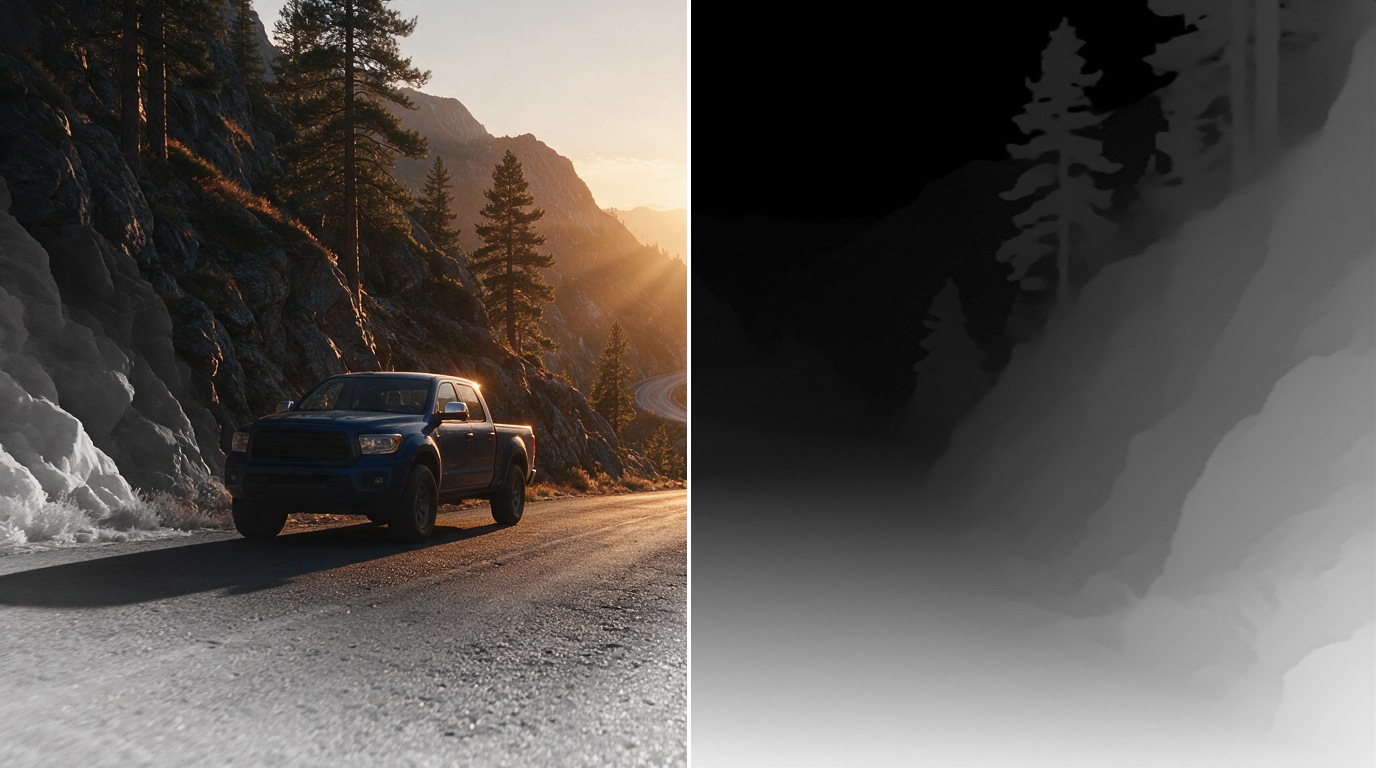
Seedance 2.5 si rifiuta di funzionare se nell'inquadratura è presente un volto riconoscibile o un pezzo del film di qualcun altro. È così che l'azienda combatte i falsi delle celebrità, ma si rivolge alla gente comune: un modello a volte rifiuta persino il proprio selfie. Esiste una soluzione alternativa e non si tratta di hacking. Il modello passa facilmente attraverso la mappa di profondità: un'immagine in bianco e nero in cui la luminosità mostra la distanza dalla fotocamera. Non ci sono volti, solo la geometria della scena. Di seguito è riportato come creare gratuitamente una mappa di questo tipo dal tuo video, direttamente nel browser, e cosa fare se la generazione continua a diminuire.
Perché una modella vede una celebrità dove non ce n'è?
I filtri Seedance vengono addestrati sui volti. Il loro compito è semplice: impedire che l'aspetto di un personaggio famoso venga falsificato. Il problema è che definiscono la “fama” dalla geometria del volto e non dal nome nei titoli di coda. La stessa forma degli occhi, la stessa forma del mento - e basta, rifiuto.
Con le riprese cinematografiche è ancora più semplice: lì funziona la protezione del copyright. La modella riconosce la scena e non la perde del tutto, anche se si desidera semplicemente ripetere il movimento della telecamera.
Risultato: due divieti diversi, ma sembra lo stesso: un errore rosso e una perdita di tempo.
Mappa di profondità: geometria al posto delle facce
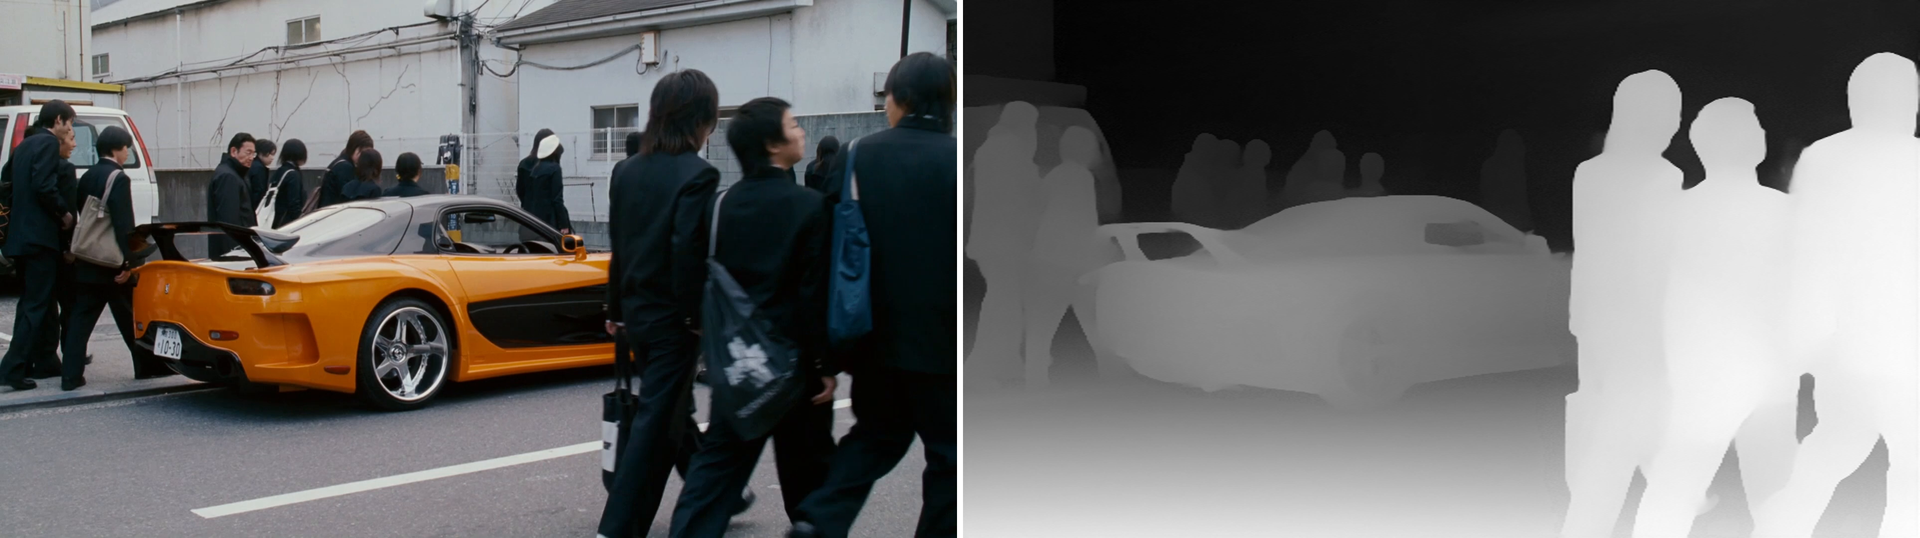
Una mappa di profondità è lo stesso video, solo ridisegnato in scala di grigi. Più l'oggetto è vicino alla fotocamera, più luminoso sarà il pixel. Lo sfondo sfuma nel nero, lo sfondo nel bianco. Niente texture, niente pelle, niente occhi: tutto ciò che rimane è il rilievo della scena.
Questo è un punto chiave per il filtro. Non c'è niente da controllare: non ci sono volti. E per generazione c'è tutto ciò di cui hai bisogno: dove erano gli oggetti, dove andava la telecamera, come è cambiato il piano. Non copiamo l'inquadratura di qualcun altro, ne prendiamo il movimento e la disposizione e la modella disegna la sua immagine, da zero.
Onestamente riguardo alla limitazione: non è un pulsante "ignora tutto". Se chiedi subito direttamente il volto di un attore specifico, il rifiuto si ripresenterà. La mappa di profondità risolve il problema della geometria e del movimento, non della sostituzione della personalità.
Come creare una mappa di profondità da un video: gratuitamente e senza caricamento sul server
Sul nostro sito web questo è un modello separato nella sezione video: Mappa della profondità (gratuita). È nell'elenco dei modelli sotto MiniMax. Seleziona un video, premi un pulsante e tutto viene calcolato sul tuo dispositivo.
Cosa c'è dentro: il modello Depth Anything V2 Small (licenza Apache 2.0) viene riprodotto direttamente nel browser tramite ONNX Runtime Web. Se hai WebGPU, conta la scheda video, altrimenti funziona il percorso di backup sul processore. I fotogrammi vengono analizzati tramite WebCodecs, quindi assemblati nuovamente in video con l'originale FPS e la risoluzione massima che il tuo browser può gestire.
L'output è MP4 o WebM: ciò che supporta il browser. C'è un'anteprima del risultato, un interruttore "Più vicino - più chiaro / Più vicino - più scuro" e tavolozze: sfumature di grigio, Inferno, Viridis. L'avanzamento dell'elaborazione è visibile fotogramma per fotogramma; l'elaborazione lunga può essere annullata.
Due cose che contano di più. Primo: il file non va da nessuna parte: né sul nostro server, né su quello di qualcun altro, tutto il lavoro si svolge sul dispositivo. Secondo: i token non vengono cancellati per questo; non esiste alcuna API a pagamento in questo modello. I pesi del modello e i file del motore vengono memorizzati nella cache del browser, quindi la pagina si avvia più velocemente la seconda volta.
Dove sarà scomodo. Ti serve Chrome o Edge - WebCodecs non è disponibile ovunque. Un video lungo su un processore non è considerato veloce: un minuto di materiale sorgente può richiedere diversi minuti. Ed è meglio non eseguire 4K su un laptop debole: inizia con 720p, guarda il risultato, quindi aumenta la risoluzione.
Sviluppo del personaggio: due errori che uccidono il risultato
La seconda tecnica dello stesso video è il corretto sviluppo del personaggio. Questa è un'immagine in cui il viso e i vestiti sono mostrati separatamente. Dipende da come è assemblato se il volto galleggerà nella generazione o rimarrà al suo posto.
Il primo errore: il viso e gli abiti sono disegnati su scale diverse. La modella non capisce che si tratta di una persona e inizia a completare le proporzioni da sola. Errore due: la scansione viene assemblata da pezzi di persone diverse, quindi l'output è una faccia aliena media e il filtro funziona di nuovo.
L'opzione di lavoro prevede una scansione, una persona, la stessa luce e la stessa angolazione su entrambe le parti.
Se la generazione fallisce ancora con un errore su una persona riconoscibile
Succede che la mappa di profondità sia a posto, la scansione sia assemblata correttamente, ma Seedance rifiuta ancora. Ciò significa che il problema è in una delle immagini e dobbiamo trovarlo.
Il metodo è semplice: il metodo di eliminazione. Togli i riferimenti uno per uno e ricominci da capo. Non appena la generazione passa, la colpa è dell'ultima immagine rimossa. Quindi lo ricostruisci o lo sostituisci con una mappa di profondità.
Per molto tempo? SÌ. Ma senza indovinare: in tre o quattro passaggi si riesce a capire il motivo esatto.
E la seconda tecnica dello stesso video: una griglia regolare viene applicata all'immagine colpevole, anche dei quadrati sul viso. Il filtro smette di vedere l'intero volto, ma per generazione i lineamenti rimangono leggibili. La griglia viene posizionata in qualsiasi editor oppure alla rete neurale viene semplicemente chiesto di “mettere una griglia quadrata su questa foto”.
Trasferisci il movimento della fotocamera da qualsiasi film
La stessa tecnica funziona senza sostituire il viso. Prendi un fotogramma da un film, ne ricavi una mappa di profondità, la dai al modello insieme al tuo suggerimento - e ottieni la scena con lo stesso movimento della telecamera: lo stesso approccio, la stessa svolta, lo stesso ritmo.
Ecco come vengono girati trailer, parodie e spot pubblicitari quando serve un giro “cinematografico”, ma non c'è budget per un cameraman con una gru.
Qual è il prossimo passo?
L'ordine è il seguente: prima la mappa di profondità - gratuito nel browser, senza scaricare un file e senza cancellare i token. Poi la generazione stessa - Seedance 2.5 sul nostro sito, c'è anche uno sviluppo del personaggio e riferimenti.
Se qualcosa non funziona la prima volta, inizia con una breve clip di 3-5 secondi. Mostra sia il movimento della telecamera che il comportamento facciale e richiede molto meno tempo e gettoni.