Chi ha parlato quando gratuitamente: separazione vocale e sottotitoli
Qualsiasi registrazione con più di una voce ti lascia con la stessa domanda: "chi l'ha detto?". Chi ha parlato quando (gratuito) risponde direttamente nel tuo browser: lo strumento trova dove iniziano e finiscono le linee, le ordina per altoparlante - "Altoparlante 1", "Altoparlante 2" e così via, fino a quattro persone - e, se vuoi, aggiunge anche il testo. Il file non viene mai caricato, non vengono addebitati token e non è necessario alcun account.
Come funziona la separazione degli altoparlanti
Il compito si chiama diarizzazione: il modello ascolta l'intero flusso e risponde a due domande separatamente: chi stava parlando e in quali minuti. Le voci vengono confrontate in base al timbro, quindi i versi della stessa persona finiscono su una traccia anche quando le persone parlano tra loro. Ciò che ottieni è una sequenza temporale: ogni riga è una linea di discorso con i propri timestamp e un'etichetta dell'oratore.
Tutto è calcolato sul tuo dispositivo. I modelli vengono scaricati nel tuo browser una volta e poi funzionano offline; su una scheda grafica tramite WebGPU l'analisi funziona notevolmente più velocemente, e se il browser non si arrende, ritorna al processore tramite WASM — corretto, ma lento. Controlla la nota sulla memoria prima di una lunga registrazione: i modelli vogliono circa un gigabyte per funzionare comodamente.
Analizzare un file passo dopo passo
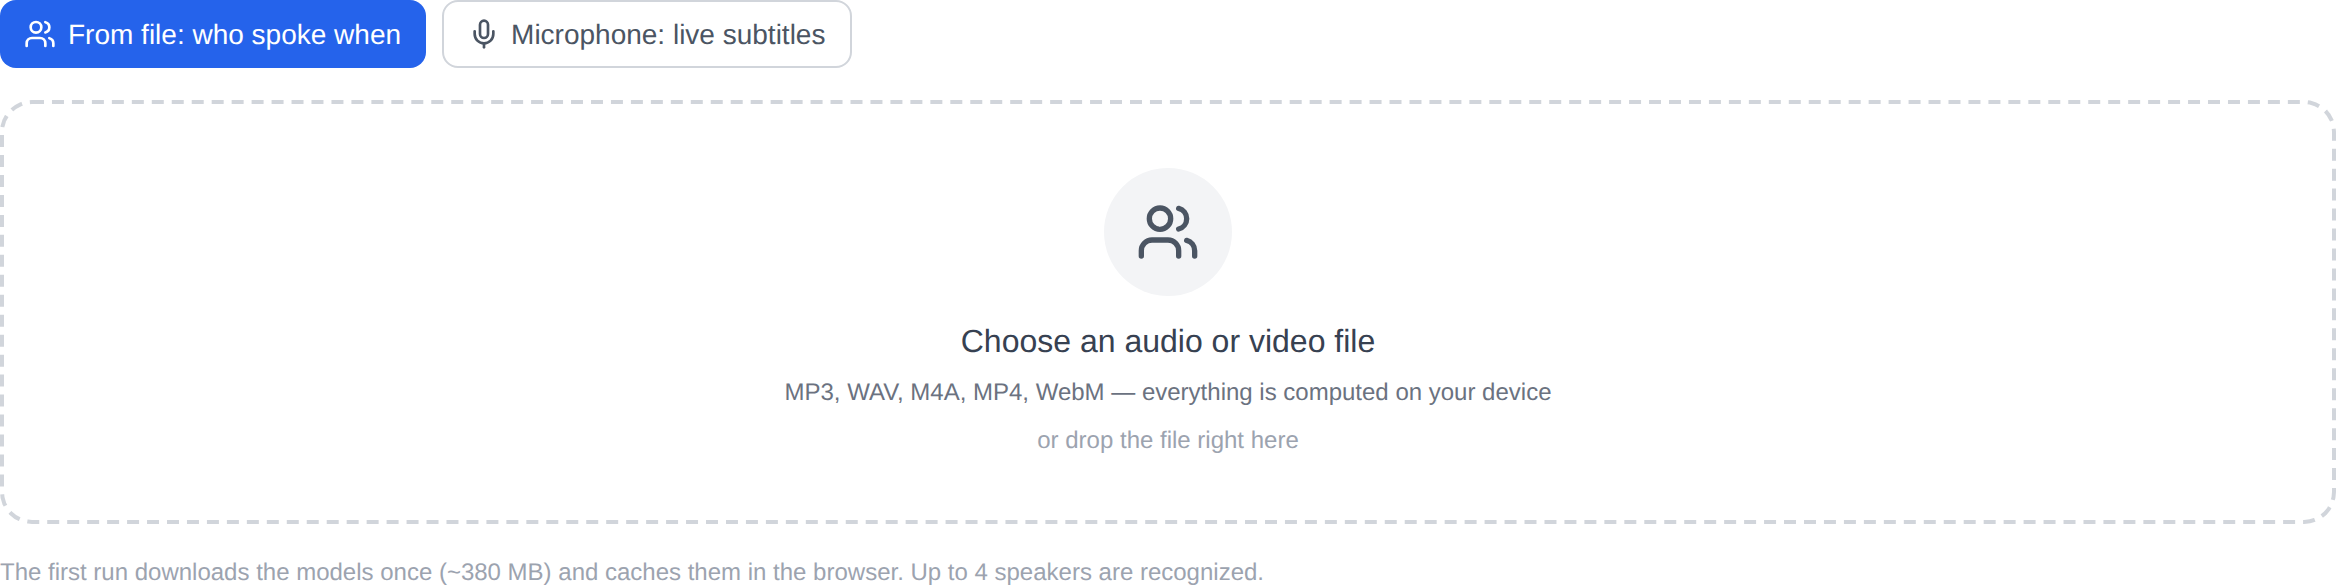
- Apri il attrezzo e, nella scheda file, scegli una registrazione: MP3, WAV, M4A, MP4, WebM e altri file multimediali sono accettati.
- La casella di controllo "Trascrivi anche il discorso" introduce il modello di testo: le parole vengono posizionate sulle tracce dell'oratore e assemblate in un dialogo leggibile. Quando è disattivato, lo strumento divide la registrazione solo per voci, il che è più veloce.
- La prima esecuzione scarica i modelli (circa 380 MB) e li memorizza nella cache; le prossime analisi iniziano subito.
- Attendi la sequenza temporale e il dialogo, quindi copia il risultato o esportalo come TXT, SRT, VTT o JSON. Nei sottotitoli SRT e VTT ogni riga porta il nome del relatore, quindi il file si collega direttamente a un editor video.
Sottotitoli in diretta dal microfono
La seconda scheda non ha bisogno di file: accendi il microfono e le frasi inizieranno ad apparire sullo schermo mentre parli. Una frase finita viene spostata nell'elenco con un timestamp mentre quella successiva si scrive sotto. L'audio non viene registrato e non viene inviato a un server: i sottotitoli risiedono solo sulla tua pagina e puoi verificarlo in qualsiasi momento con la scheda Rete nei tuoi strumenti di sviluppo. È adatto a chiamate, riunioni e conferenze in cui è necessaria la trascrizione mentre la conversazione è ancora in corso, non dopo.
Limiti onesti
Questo è uno strumento di separazione degli altoparlanti, non un trascrittore universale. Il modello di riconoscimento vocale è stato addestrato principalmente sull'inglese: trascriverà una conversazione in un'altra lingua, ma con molti più errori rispetto a quella inglese. Fino a quattro altoparlanti sono separati in modo affidabile; una registrazione effettuata in una sala rumorosa con interruzioni sarà sicuramente peggiore di un'intervista tranquilla. Una trascrizione con i nomi dei relatori non è una trascrizione professionale, quindi rileggila prima di trasmetterla.
L'hardware è l'altro limite: un dispositivo debole potrebbe non avere memoria sufficiente per i modelli e l'analisi del solo processore richiede un po' di tempo. In cambio il prezzo è fisso: niente code, niente spese, niente caricamenti.
A chi si adatta
Un giornalista può vedere la struttura di un'intervista ed estrarre le citazioni in pochi minuti. Un ospitante della riunione può ottenere un record "chi ha detto cosa" senza sfogliare il nastro. Un editor video può inserire i sottotitoli con i nomi dei relatori in un progetto tramite SRT o VTT. Uno studente può suddividere una lezione in linee e punti di discussione.
Se hai bisogno di testo senza separazione dei relatori e in molte lingue, riconoscimento vocale (gratuito) corre a fianco. Il resto della sezione vive di Audio pagina e gli strumenti locali gratuiti sono raccolti in Altri strumenti. Inizia con una breve registrazione di cinque minuti: è sufficiente una prima esecuzione con il download del modello per sentire come le tue registrazioni sopravvivono all'analisi.