DeepSeek V4 Pro 0813 adalah titik balik sejarah
Secara singkat tentang hal utama (BLUF)
DeepSeek merilis versi final V4 Pro - revisi 0813: pembaruan tiba secara otomatis melalui API, tanpa presentasi atau referensi. Kami melihat apa sebenarnya yang meningkat menggunakan benchmark, menghitung dengan jujur perbedaannya dengan Claude dan GPT dan menjelaskan mengapa harganya belum berubah.
Hari ini DeepSeek meluncurkan versi final V4 Pro - revisi 0813. Tidak ada konferensi atau penghitung mundur: baru saja memperbarui API. Mereka yang telah bekerja dengan `deepseek-v4-pro` secara otomatis menerima model baru tanpa mengubah kode apa pun. Yang April adalah pratinjau, yang ini GA, dan perbedaannya terlihat terutama ketika model diharapkan tidak merespons dalam obrolan, tetapi bekerja secara koheren.

Hari ini adalah hari ketika pengkodean tingkat Opus benar-benar dapat diakses.Proposal ini akan menjadi impian pemasar di pagi hari, dan di malam hari akan menjadi fakta dengan tolok ukur yang dapat diandalkan.
Di NeuralSpace modelnya sudah berdiri:dalam obrolan, V Bagian "Kode".dan masukAPI. Tidak perlu “menunggu peluncurannya”—Anda membukanya dan menggunakannya.
Model apa
Secara teknis, ini adalah hal yang sama seperti pada bulan April: Campuran Pakar dengan 1,6 triliun parameter, dimana 49 miliar di antaranya aktif di setiap langkah. Konteksnya adalah satu juta token, dan model tersebut mampu menghasilkan hingga 384 ribu token dalam satu respons. Sebagai perbandingan: ini sekitar dua puluh kali lebih banyak daripada kebanyakan model di tab tetangga.
Model dapat berpikir dalam dua mode - berpikir dan non-berpikir, dan Reasoning_effort kini memiliki tiga level: maks, tinggi, rendah. Dalam praktiknya, ini berarti bahwa masalah kecil dapat diselesaikan dengan biaya murah, dan rantai masalah yang rumit dapat diselesaikan dengan pemikiran maksimal, tanpa mengubah model.
Tolok ukur: apa sebenarnya yang telah berkembang
Analisis Buatan mengukur ulang versi final. Indeks Intelegensi meningkat dari 43,7 menjadi 45,3. Indeks Pengkodean - dari 58,7 hingga 59,4. Namun Indeks Agentik melonjak paling tinggi: dari 35,3 menjadi 37,8. Ini bukan suatu kebetulan - revisi 0813 telah diperbaiki secara khusus untuk skenario berbasis agen, di mana model tidak merespons sekaligus, tetapi bolak-balik: membaca file, memanggil alat, melihat hasilnya, dan mengoreksi dirinya sendiri.
Dalam hal kecepatan, semuanya berada pada level versi sebelumnya: sekitar 76 token per detik pada output, token pertama tiba dalam waktu sekitar satu setengah hingga dua detik. Itu cepat untuk model sebesar ini. Sisi negatifnya: modelnya banyak bicara. Pada pengukuran AA, ia mengeluarkan token satu setengah hingga dua kali lebih banyak daripada rata-rata pasar - pertimbangkan bahwa untuk alasan terperinci Anda membayar dengan token ekstra dan waktu tunggu ekstra.
Melawan Claude dan GPT: aritmatika yang adil
Hal yang paling mencolok di tabel terbaru adalah jajaran Claude Opus 4.8, mantan andalan Anthropic. DeepSeek V4 Pro 0813 mengalahkannya dalam benchmark pengkodean di kedua sisi: Terminal-Bench 2.1 - 87.9 versus 85.0, DeepSWE - 62.7 versus 58.0. Pada saat yang sama, Opus 4.8 berharga $5 per juta token masukan dan $25 per juta token keluaran – 11 dan 29 kali lebih mahal. Berikut tabelnya:
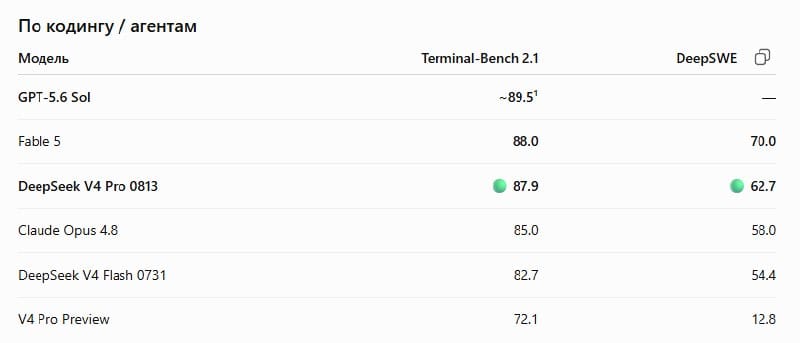
Versi final paling mendekati Claude Fable 5: 87,9 versus 88,0 di Terminal-Bench—perbedaan sepersepuluh. Menurut DeepSWE, Fable lebih unggul: 70,0 versus 62,7. Jika Anda menghitung sepuluh tolok ukur berbasis agen dari tabel DeepSeek, Fable unggul dengan rata-rata 5,3% - namun pada dua dari sepuluh kemenangan DeepSeek, dan tanpa satu-satunya outlier (Ujian Terakhir Kemanusiaan tanpa alat: 42,7 vs 53,3) rata-rata prospek menyusut menjadi 2,8%.
Harganya berbeda bukan berdasarkan persentase, tetapi beberapa kali lipat. Fable 5 berharga $10 per juta input dan $50 per juta token output; V4 Pro memiliki $0,435 dan $0,87. Pada tarif campuran, hasilnya sekitar $30 versus $0,65. Artinya, untuk selisih beberapa persen dalam tes, Anthropic meminta bayaran kurang lebih 46 kali lipat. Peringatan kejujuran: Saya sendiri yang mengukur tabel perbandingan DeepSeek, pada infrastruktur saya sendiri yang tidak dipublikasikan, dua dari sepuluh pengujian bersifat internal, dan belum ada pengukuran independen pada 0813 - model tersebut baru dirilis hari ini.
Untuk memahami skalanya, pikirkan tentang Kimi K3. Sebulan yang lalu, dia menjadi model Tiongkok pertama yang menyalip Claude Opus - itu adalah sebuah sensasi. Tapi Kimi K3 adalah model dengan triliunan parameter, membutuhkan server yang mahal untuk dijalankan, jadi secara retail hanya tiga kali lebih murah dari Claude Fable dan hanya 40% lebih murah dari Claude Opus. Mengesankan, namun tidak ada demokratisasi dalam hal ini.
Namun DeepSeek V4 Pro adalah momen yang benar-benar bersejarah. Benar-benar menyamai Opus dalam hal pengkodean, biayanya 30 kali lebih murah dari Opus dan 60 kali lebih murah dari Fable. Saat ini, pengkodean getaran telah dapat diakses oleh semua orang—bukan dalam arti “tersedia” dalam periklanan, namun dengan biaya untuk masuk ke dalamnya.
Dengan GPT, situasinya menjadi lebih rumit. GPT-5.5 mendapat skor 56,3 dalam indeks Analisis Buatan dibandingkan 45,3 untuk DeepSeek - kesenjangannya sejujurnya terlihat jelas. Namun tarifnya tidak sebanding: $5/$30 per juta versus $0,435/$0,87. Namun Luna GPT-5.6 yang lebih murah sudah berharga $0,10/$0,60 - lebih murah daripada DeepSeek - dan mendapat skor 52,3. Ternyata yang “termurah dari yang besar” bukan lagi satu-satunya: dari segi harga, V4 Pro bersaing dengan Luna, dan dari segi poin kalah dari Terra dan Sol.
Saya akan menambahkan kutipan sederhana dari luar: penilaian terbaru dari NIST Amerika (CAISI) mengatakan bahwa V4 Pro tertinggal sekitar delapan bulan dari pemimpin pasar. Benar, mereka mengukur versi pratinjau. Apakah 0813 telah mempersempit kesenjangan ini akan ditunjukkan oleh tolok ukur independen, namun tolok ukur tersebut belum ada.
Harganya tidak berubah. Selamat tinggal
Masuk – $0,435 per juta token, keluar – $0,87. Cash hit masih hampir gratis: $0,003625 per juta, 120 kali lebih murah dibandingkan entri reguler. Untuk rantai agen, ini adalah poin utamanya: konteks proyek dibaca berulang kali, dan cachelah yang menentukan berapa biaya kerja agen dalam satu jam.
Satu peringatan: DeepSeek telah memperingatkan dalam dokumentasinya bahwa mereka akan menaikkan harga API-nya secara keseluruhan. Kapan dan berapa lama tidak disebutkan. Tarif bulan April masih berlaku, dan tarif ini jauh lebih rendah dibandingkan tarif serupa di negara Barat.
Di mana mencobanya sekarang
- Mengobrol:membukahalaman model— angka 0813 terakhir sudah menjadi default.
- Kode: V Bagian "Kode".model terhubung ke proyek dan bekerja dengan repositori, file, dan terminal.
- API:kuncinya dikeluarkan di bagian tersebutKunci API NeuralSpace, format yang kompatibel dengan OpenAI.
Pembayaran - dalam rubel dari saldo umum, tanpa berlangganan, VPN, atau kartu asing. Penggunaan sebenarnya dihapuskan, bukan paket “bulan sebelumnya”.
Yang tidak bisa dilakukan model adalah melihat gambar: masukannya hanya berupa teks. Jika Anda memerlukan analisis tangkapan layar atau foto, ini untuk model lain. Namun untuk tugas teks, kode, dan agen panjang, V4 Pro final kini menjadi salah satu proposal paling jujur dalam hal rasio daya dan harga.Anda dapat memeriksanya di obrolan, dan jika Anda perlu memasukkannya ke dalam produk Anda -kuncinya diambil dari halaman kunci API.
Pertanyaan yang sering diajukan (FAQ)
Pertanyaan: Bagaimana cara memulainya?Jawaban: Daftar di platform dan terima token gratis untuk pengujian.
Pertanyaan: Apakah materi yang dihasilkan cocok untuk penggunaan komersial?Jawaban: Ya, Anda menerima hak komersial penuh atas semua konten yang dibuat.