Tendance : une fille dans les tribunes d'un match coréen - comment elles font
En bref sur l'essentiel (BLUF)
Une fille dans les tribunes d'un match coréen est une tendance qui a récolté des millions de vues : la caméra retrouve l'héroïne parmi les fans, mais elle ne semble pas remarquer le tournage. Examinons deux modèles : photos et vidéos, comment cela fonctionne sous le capot et où la tendance se brise.
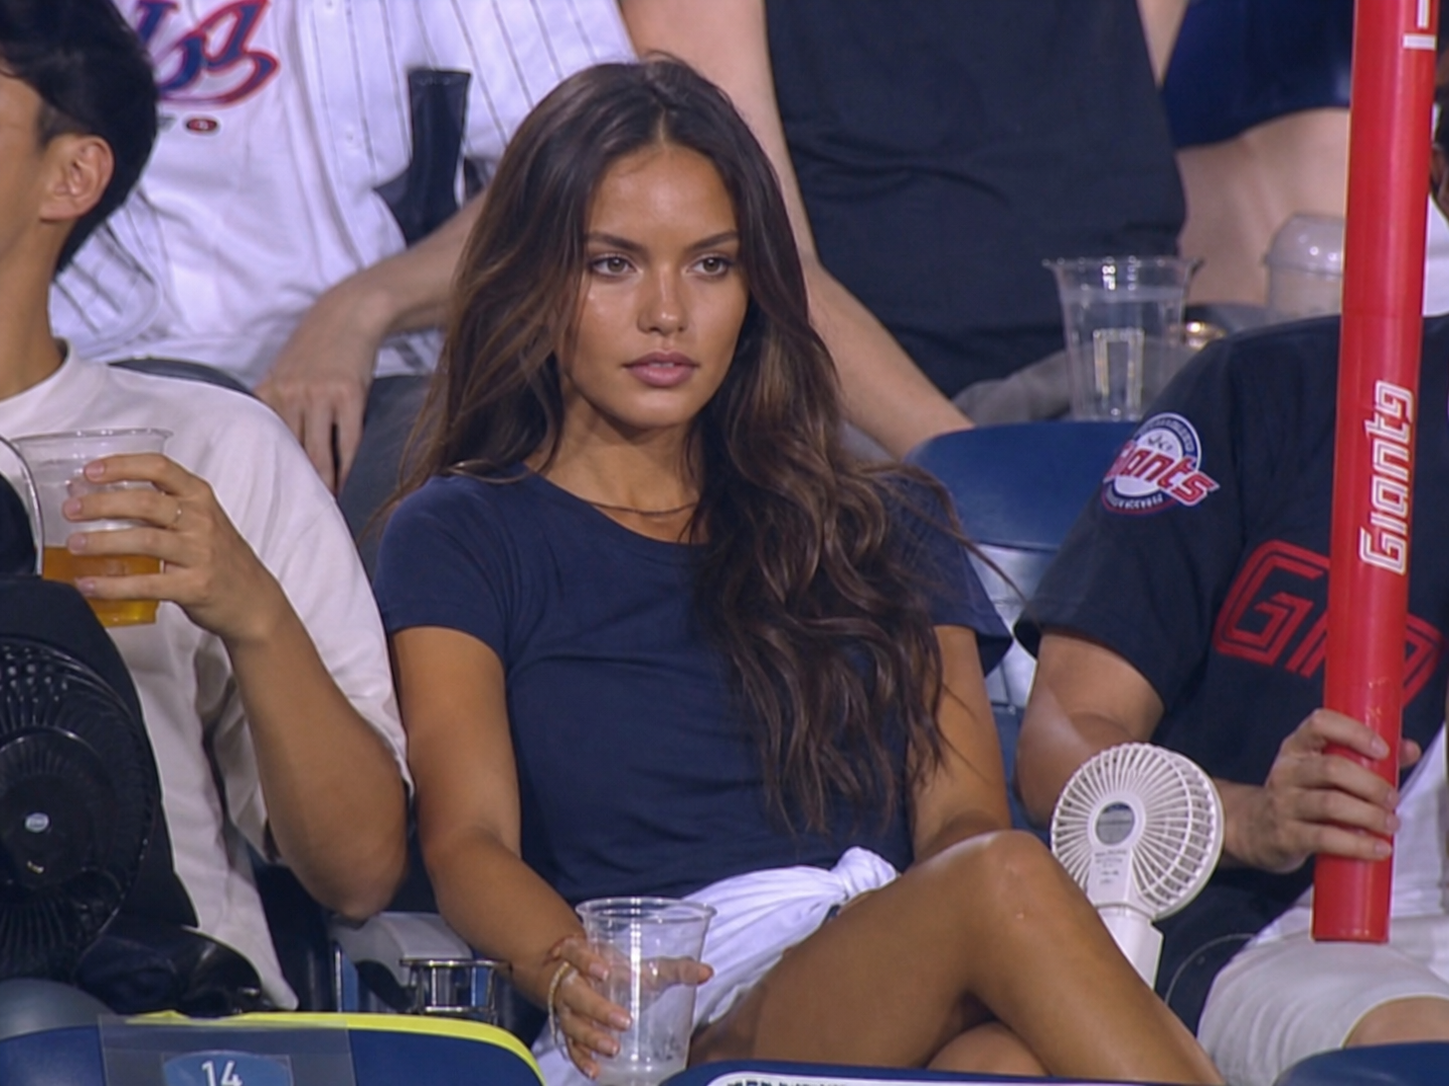
Regardez attentivement l'un de ces rails. Chaîne de télévision coréenne, logo SPOTV, tableau d'affichage avec manches. La caméra regarde le podium - la jeune fille est assise, ne regarde pas l'objectif, regarde quelque part vers le champ. 5 secondes. Tous.
La vidéo compte un million de vues. Dans les commentaires : « où avez-vous eu cette vidéo », « étiez-vous vraiment en Corée », « est-ce un réseau de neurones ou un réseau en direct ». Et la plupart des gens n’arrivent pas à le comprendre. Voici pourquoi.
Deux modèles : photo et vidéo
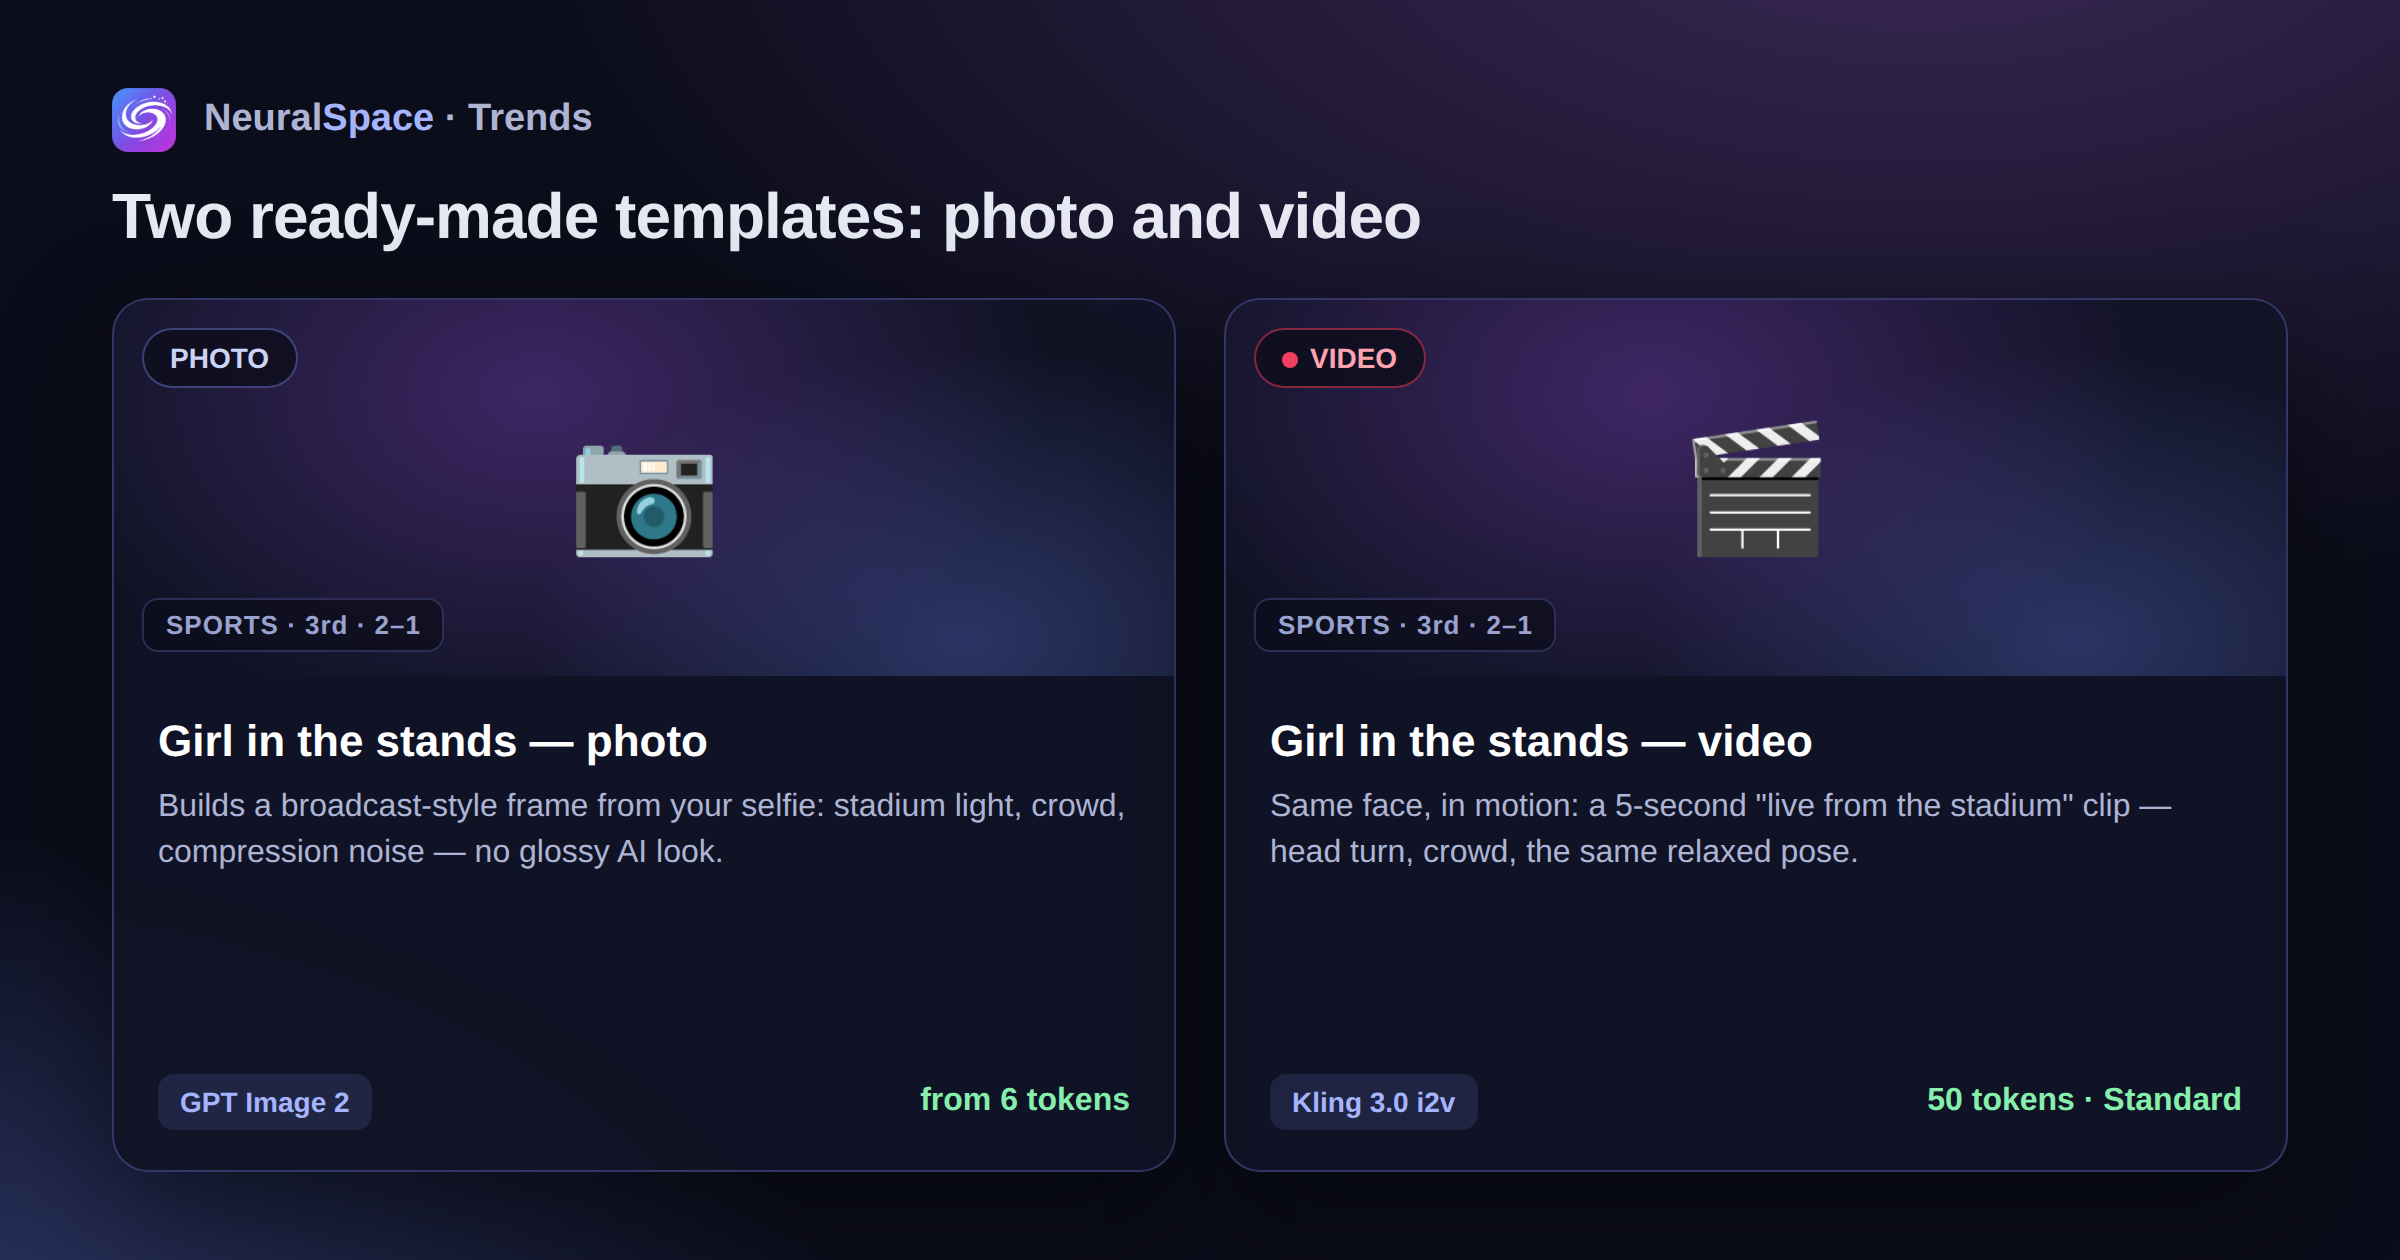
"Fille sur le podium - photo." Il prend une photo de votre visage et réalise un cadre de toutes pièces à la manière d'une émission SPOTV : tribunes, lumières du stade, supporters typiquement coréens en arrière-plan, un verre en plastique à la main, un éventail sur le côté. Sans une apparence IA raffinée - au contraire, avec un bruit de compression, un léger flou de mouvement et une vraie peau. Le but est de faire en sorte que cela ressemble à une photo diffusée au hasard, et non à une séance photo de mode. Sous le capot - GPT Image 2. A partir de 6 tokens par génération.
"Fille sur le podium - vidéo." Le même visage, mais en mouvement. Vous téléchargez une photo - le modèle image-vidéo Kling 3.0 réalise un clip de 5 secondes « en direct du stade » : le même angle de caméra de diffusion, la foule en arrière-plan, la même pose détendue. 50 jetons en mode Standard, ou plus en mode Pro.
Comment ça marche sous le capot
Photo. Il n’y a pas de frame, il est généré à partir de zéro. Mais avec des règles strictes : pas de retouches, pas d'« agrandissement des yeux », pas de gloss plastique. La demande indique explicitement : cela doit ressembler à des images réelles provenant d'une caméra de diffusion de mauvaise qualité, avec tous ses défauts - légères bavures, bruit numérique, reflets de sueur. C'est ce qui donne la sensation d'un « vrai cadre », et non d'un « neurone ».
Vidéo. Kling 3.0 image-vidéo prend votre photo comme première image et anime la scène à la demande : léger tour de tête, mouvement de la foule en arrière-plan, clignements des yeux, expressions faciales d'un « regard étonnamment concentré sur le terrain ». L'invite nécessite clairement une image horizontale 16:9 et une qualité de diffusion afin qu'elle s'intègre dans le format des rouleaux recadrés et ne ressemble pas à I2V avec un étirement vertical.
Comment le faire manuellement
Si vous ne souhaitez pas utiliser le modèle :
Pour les photos. Allez-vous rubrique images, sélectionnez GPT Image 2, joignez un selfie comme référence et rédigez une demande en coréen (le modèle la comprend mieux dans le contexte de la télévision coréenne) :
Pour la vidéo. Allez-vous section vidéo, sélectionnez Kling 3.0, joignez la même photo (vous pouvez d'abord la prendre dans un modèle photo), 16:9, demandez :
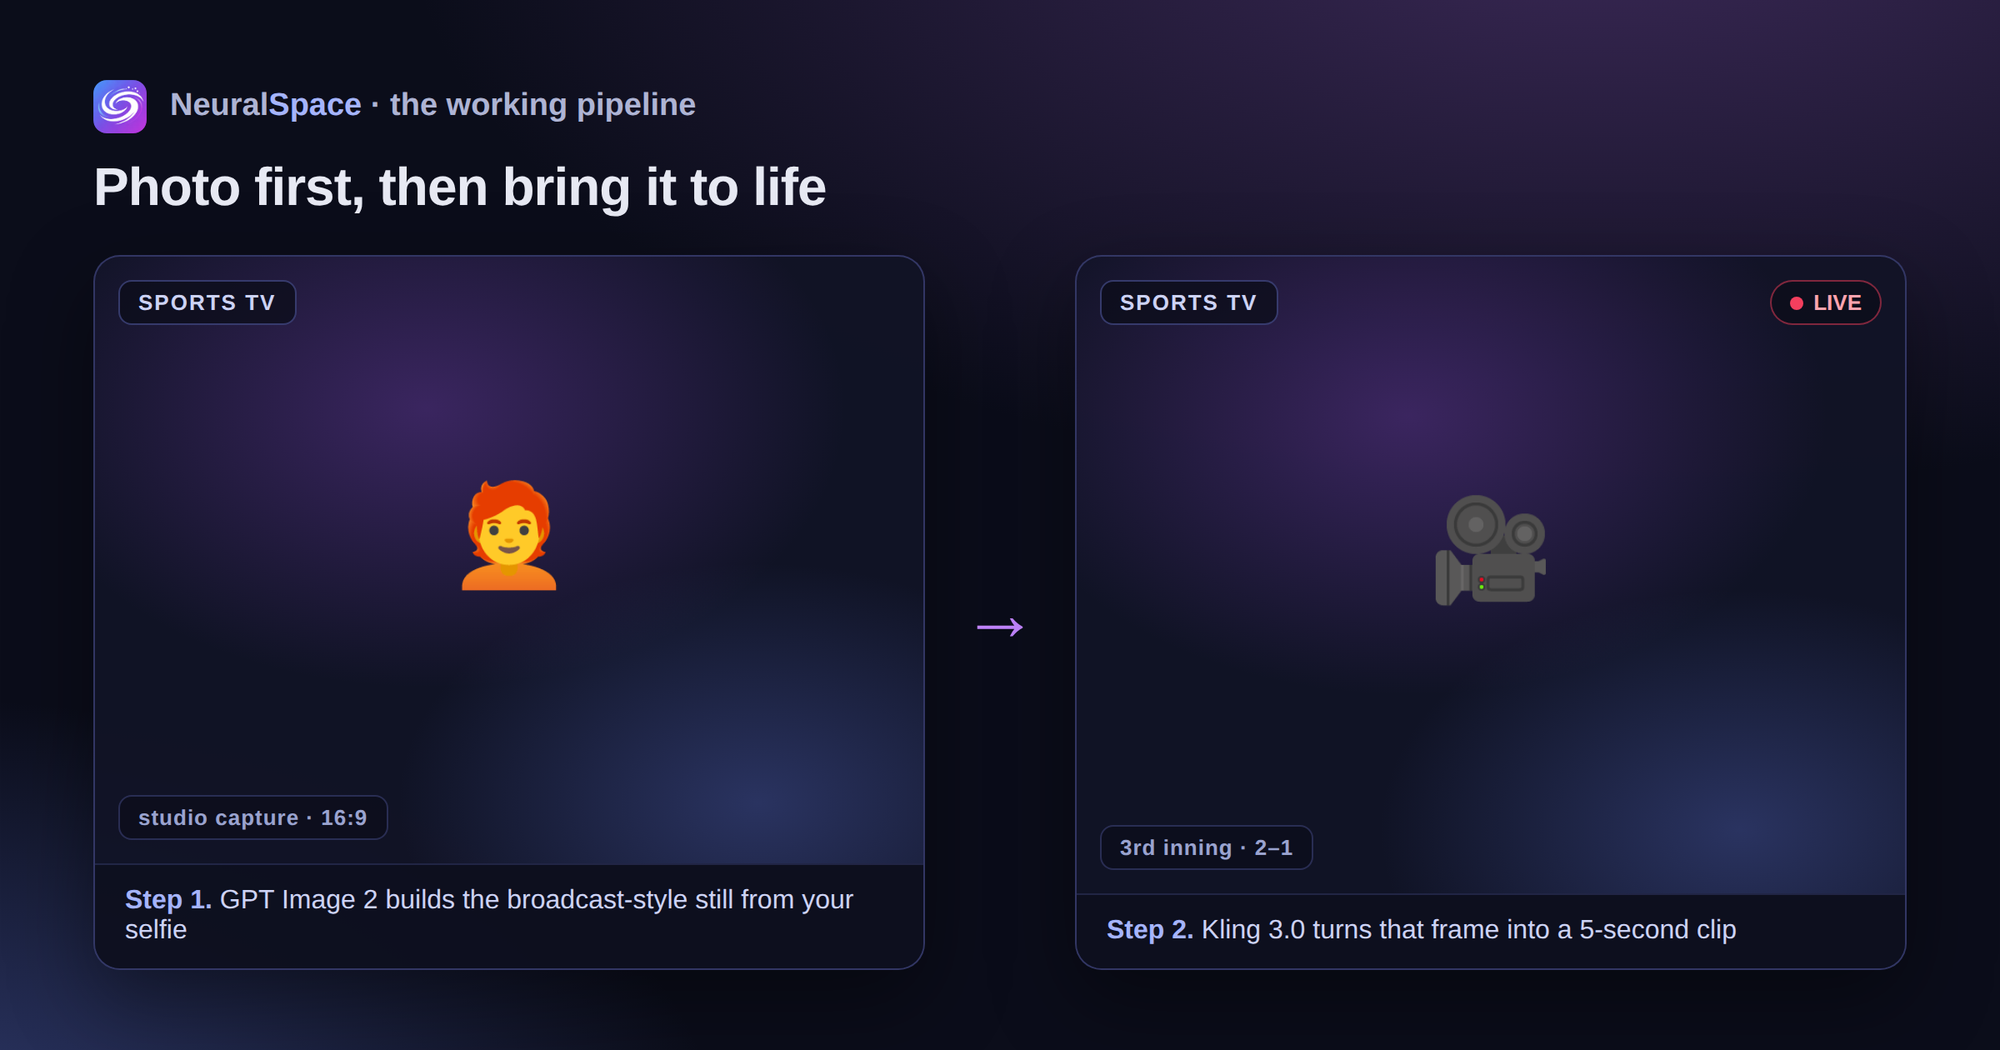
C'est-à-dire un pipeline fonctionnel : d'abord un modèle photo (vous obtenez le cadre de « diffusion » parfait), puis vous jetez ce cadre dans un modèle vidéo - et vous obtenez 5 secondes d'une version animée de la même personne sur le podium.
Où ça casse
Photo. Le selfie de référence est trop clair et lumineux - le modèle essaie de faire glisser sa « brillance » dans le cadre, et le résultat n'est pas une diffusion, mais une séance photo de mode. Un simple selfie sans filtres fonctionne mieux. Si le résultat est trop beau, régénérez-le, la demande contient déjà tous les interdits de retouche, mais parfois le modèle est encore attiré vers « l'influenceur ».
Vidéo. Kling 3.0 donne un bon mouvement de la tête et de l'arrière-plan, mais si la photo est trop « studio » (fond blanc plat, lumière parfaite), il attire cette lumière dans la scène du stade et vous obtenez un mélange étrange. Les photos de portrait fonctionnent mieux avec une lumière moyenne, sans ombres dures.
Essayer
Deux modèles prêts à l'emploi dans Rubrique Tendances. Si vous souhaitez une image statique pour une publication, utilisez une carte photo sur GPT Image 2. Si vous souhaitez une vidéo de 5 secondes pour une bobine, utilisez une carte vidéo sur Kling 3.0. Vous pouvez le faire en groupe : d'abord une photo, puis à partir de cette photo - une vidéo.
Questions fréquemment posées (FAQ)
Question : Comment obtenir le meilleur résultat d’un réseau de neurones ?
Réponse : Utilisez des invites détaillées (descriptions) en anglais, définissez le style et les détails de la scène.
Question : Ces matériaux peuvent-ils être utilisés à des fins commerciales ?
Réponse : Oui, le contenu généré vous appartient entièrement.