Qui a parlé quand gratuitement : séparation des voix et sous-titres
Tout enregistrement avec plus d’une voix vous laisse avec la même question : « qui a dit ça ? ». Qui a parlé quand (gratuit) y répond directement dans votre navigateur : l'outil trouve où commencent et se terminent les lignes, les trie par locuteur — "Haut-parleur 1", "Haut-parleur 2" et ainsi de suite, jusqu'à quatre personnes — et, si vous le souhaitez, ajoute également le texte. Le fichier n'est jamais téléchargé, aucun jeton n'est facturé et aucun compte n'est nécessaire.
Comment fonctionne la séparation des enceintes
La tâche s'appelle la diarisation : le modèle écoute l'intégralité du flux et répond à deux questions séparément : qui parlait et dans quelles minutes. Les voix sont comparées par timbre, de sorte que les lignes d'une même personne atterrissent sur une seule piste même lorsque les gens se parlent. Ce que vous obtenez est une chronologie : chaque ligne est une ligne de discours avec ses propres horodatages et une étiquette de locuteur.
Tout est calculé sur votre appareil. Les modèles sont téléchargés une fois dans votre navigateur, puis fonctionnent hors ligne ; sur une carte graphique via WebGPU, l'analyse s'exécute sensiblement plus rapidement, et si le navigateur n'en abandonne pas, elle revient au processeur via WASM — correct, mais lent. Vérifiez la note mémoire avant un long enregistrement : les modèles veulent environ un gigaoctet pour fonctionner confortablement.
Analyser un dossier étape par étape
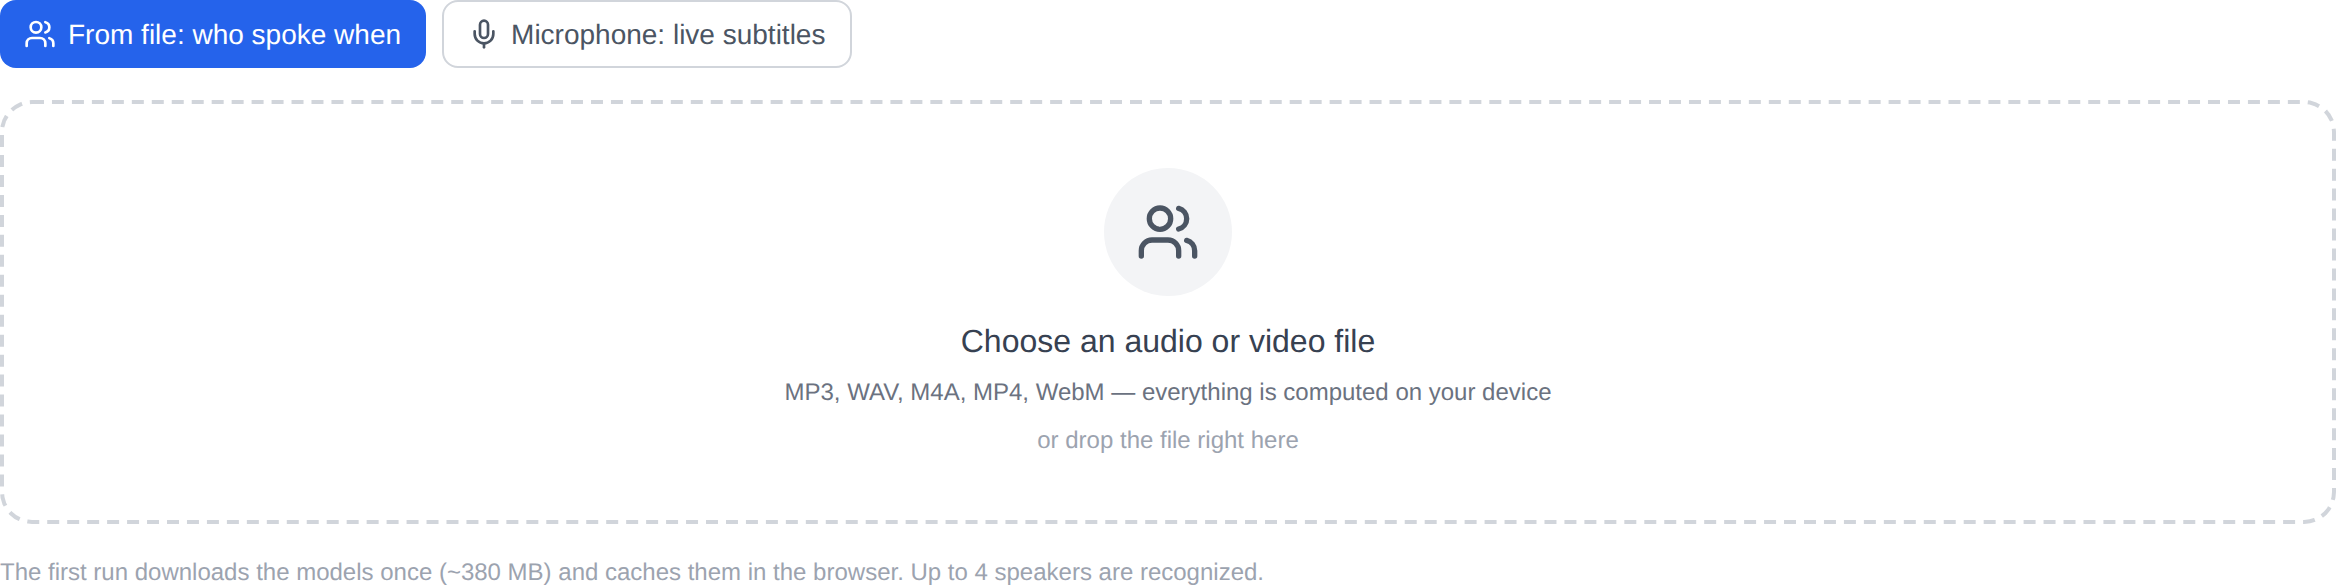
- Ouvrez le outil et, dans l'onglet Fichier, choisissez un enregistrement : MP3, WAV, M4A, MP4, WebM et d'autres fichiers multimédias sont acceptés.
- La case à cocher « Transcrire également le discours » fait apparaître le modèle de texte : les mots sont déposés sur les pistes du locuteur et assemblés dans un dialogue lisible. Lorsqu'il est désactivé, l'outil divise uniquement l'enregistrement par voix, ce qui est plus rapide.
- La première exécution télécharge les modèles (environ 380 Mo) et les met en cache ; les prochaines analyses démarrent immédiatement.
- Attendez la chronologie et le dialogue, puis copiez le résultat ou exportez-le sous TXT, SRT, VTT ou JSON. Dans les sous-titres SRT et VTT, chaque ligne porte son nom de locuteur, le fichier se connecte donc directement à un éditeur vidéo.
Sous-titres en direct depuis le microphone
Le deuxième onglet ne nécessite aucun fichier : allumez votre microphone et les phrases commencent à apparaître à l'écran pendant que vous parlez. Une phrase terminée se déplace dans la liste avec un horodatage tandis que la suivante se tape en dessous. Le son n'est pas enregistré et n'est pas envoyé à un serveur — les sous-titres vivent uniquement sur votre page, et vous pouvez le vérifier à tout moment avec l'onglet réseau de vos outils de développement. Cela convient aux appels, aux réunions et aux conférences pour lesquels vous avez besoin de la transcription pendant que la conversation est en cours, et non après.
Des limites honnêtes
Il s'agit d'un outil de séparation des locuteurs, pas d'un transcripteur universel. Le modèle de reconnaissance vocale a été formé principalement sur l'anglais : il transcrira une conversation dans une autre langue, mais avec sensiblement plus d'erreurs qu'une conversation en anglais. Jusqu'à quatre haut-parleurs sont séparés de manière fiable ; un enregistrement dans une salle bruyante avec des interruptions sera bien pire qu'une interview calme. Une transcription avec les noms des intervenants n’est pas une transcription professionnelle, alors relisez-la avant de la transmettre.
Le matériel constitue l'autre limite : un appareil faible peut ne pas disposer de suffisamment de mémoire pour les modèles, et l'analyse uniquement par le processeur prend un certain temps. En échange, le prix n'est fixé à rien : pas de files d'attente, pas de frais, pas de téléchargements.
À qui convient-il
Un journaliste peut voir la structure d’une interview et extraire des citations en quelques minutes. Un organisateur de réunion peut obtenir un enregistrement de « qui a dit quoi » sans parcourir la bande. Un éditeur vidéo peut intégrer des sous-titres avec les noms des locuteurs dans un projet via SRT ou VTT. Un étudiant peut diviser un cours en lignes et en points de discussion.
Si vous avez besoin de texte sans séparation des locuteurs et dans de nombreuses langues, reconnaissance vocale (gratuite) court à côté. Le reste de la section vit sur le Audio page, et les outils locaux gratuits sont rassemblés sous Autres outils. Commencez par un court enregistrement de cinq minutes : une première exécution avec le téléchargement du modèle suffit pour entendre comment vos enregistrements survivent à l'analyse.