Carte de profondeur pour Seedance 2.5 : comment contourner le blocage du visage
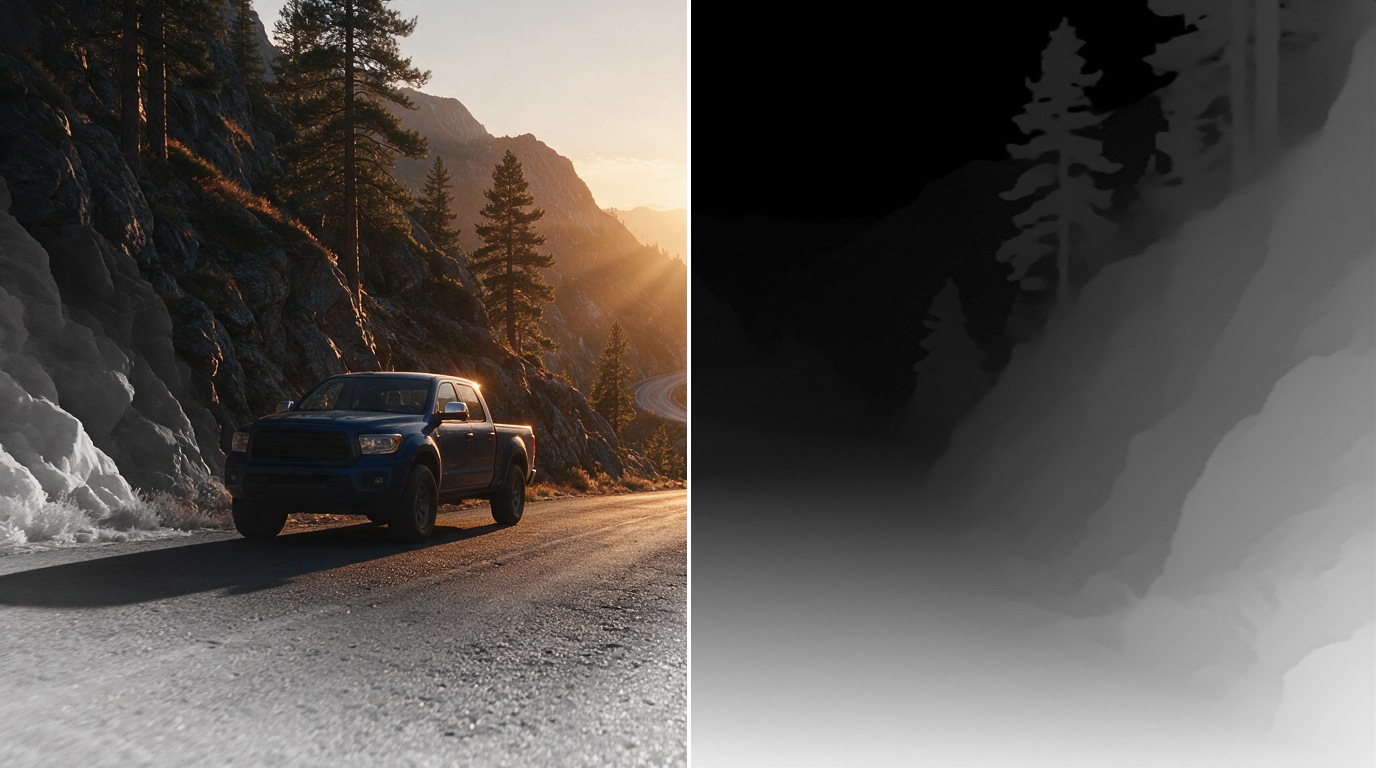
Seedance 2.5 refuse de fonctionner s’il y a un visage reconnaissable ou un morceau du film de quelqu’un d’autre dans le cadre. C'est ainsi que l'entreprise lutte contre les contrefaçons de célébrités, mais cela s'adresse aux gens ordinaires : un mannequin rejette parfois même son propre selfie. Il existe une solution de contournement, et il ne s’agit pas de piratage. Le modèle passe facilement par la carte de profondeur - une image en noir et blanc où la luminosité indique la distance à la caméra. Il n’y a pas de visages dessus, seulement la géométrie de la scène. Vous trouverez ci-dessous comment créer gratuitement une telle carte à partir de votre vidéo, directement dans le navigateur, et que faire si la génération continue de baisser.
Pourquoi un mannequin voit-il une célébrité là où il n’y en a pas ?
Les filtres Seedance sont entraînés sur les visages. Leur tâche est simple : empêcher que l’apparence d’une personne célèbre ne soit truquée. Le problème c’est qu’ils définissent la « célébrité » par la géométrie du visage, et non par le nom au générique. Une forme d’œil similaire, la même forme de menton – et c’est tout, refus.
C’est encore plus simple avec les séquences cinématographiques : la protection des droits d’auteur y fonctionne. Le modèle reconnaît la scène et ne la rate pas entièrement, même si l'on souhaite simplement répéter le mouvement de la caméra.
Résultat : deux interdictions différentes, mais cela se ressemble : une erreur rouge et une perte de temps.
Carte de profondeur : géométrie au lieu de faces
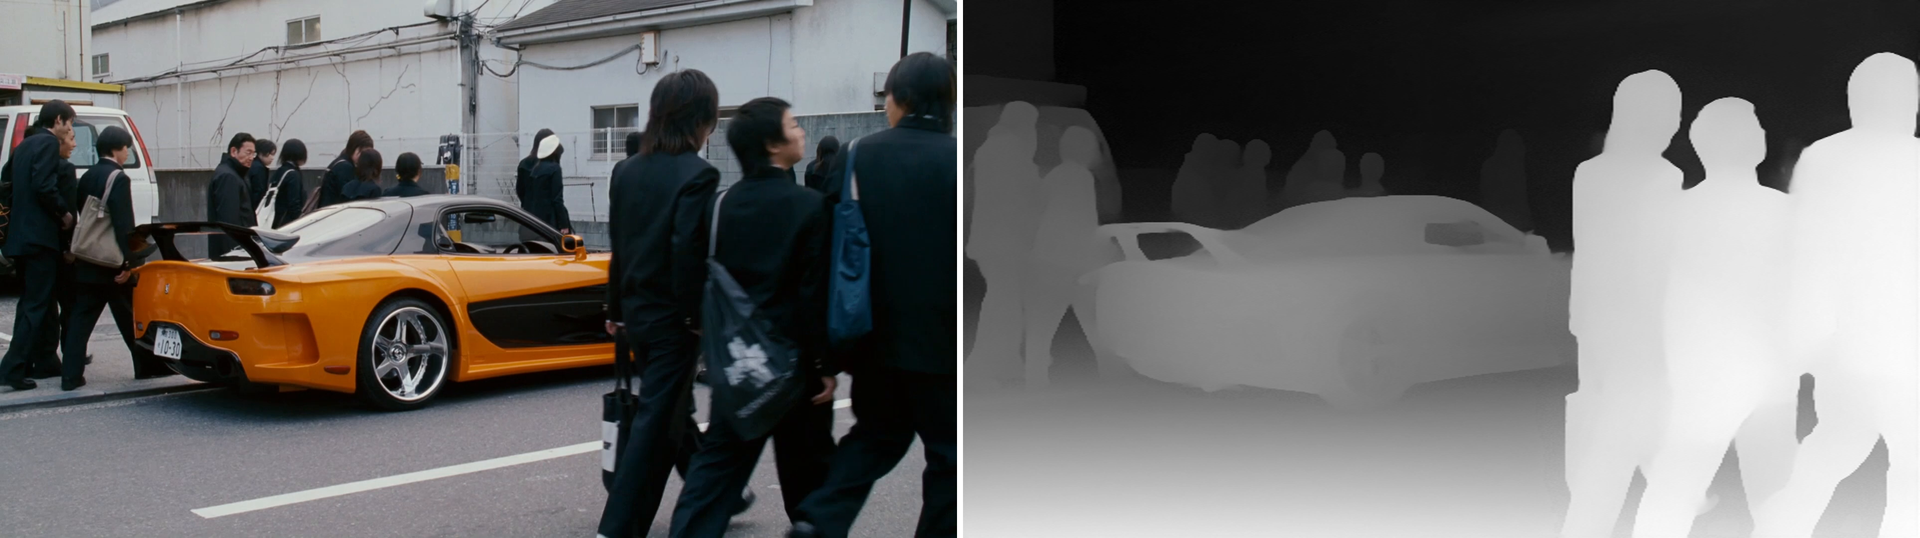
Une carte de profondeur est la même vidéo, uniquement redessinée en niveaux de gris. Plus l'objet est proche de la caméra, plus le pixel est lumineux. L'arrière-plan devient noir, l'arrière-plan devient blanc. Pas de textures, pas de peau, pas d'yeux : seul reste le relief de la scène.
C’est un point clé pour le filtre. Il n'y a rien à vérifier, il n'y a pas de visages. Et pour la génération, il y a tout ce dont vous avez besoin : où se trouvaient les objets, où allait la caméra, comment le plan a changé. Nous ne copions pas le cadre de quelqu’un d’autre, nous en reprenons le mouvement et la disposition, et le modèle dessine sa propre image, à partir de zéro.
Honnêtement, à propos de la limitation : il ne s’agit pas d’un bouton « tout contourner ». Si vous demandez rapidement et directement le visage d'un acteur spécifique, le refus reviendra. La carte de profondeur résout le problème de la géométrie et du mouvement, et non de la substitution de personnalité.
Comment créer une carte de profondeur à partir d'une vidéo - gratuitement et sans téléchargement sur le serveur
Sur notre site Web, il s'agit d'un modèle distinct dans la section vidéo : Carte de profondeur (gratuite). Il est dans la liste des modèles sous MiniMax. Vous sélectionnez une vidéo, appuyez sur un bouton et tout est calculé sur votre appareil.
Qu'y a-t-il à l'intérieur : le modèle Depth Anything V2 Small (licence Apache 2.0) joue directement dans le navigateur via ONNX Runtime Web. Si vous avez WebGPU, la carte vidéo compte, sinon le chemin de sauvegarde sur le processeur fonctionne. Les images sont analysées via WebCodecs, puis réassemblées en vidéo avec le FPS d'origine et la résolution maximale que votre navigateur peut gérer.
Le résultat est MP4 ou WebM – ce que le navigateur prend en charge. Il y a un aperçu du résultat, un switch « Plus proche - plus clair / Plus proche - plus foncé » et des palettes : nuances de gris, Inferno, Viridis. La progression du traitement est visible image par image ; un traitement long peut être annulé.
Deux choses qui comptent le plus. Premièrement : le fichier ne va nulle part - ni vers notre serveur, ni vers celui de quelqu'un d'autre, tout le travail s'effectue sur l'appareil. Deuxièmement : les jetons ne sont pas radiés pour cela ; il n'y a pas du tout d'API payante dans ce modèle. Les poids du modèle et les fichiers du moteur sont mis en cache dans le navigateur, de sorte que la page démarre plus rapidement la deuxième fois.
Où ce sera inconfortable. Il vous faut Chrome ou Edge - WebCodecs n'est pas disponible partout. Une longue vidéo sur un processeur n'est pas considérée comme rapide : une minute de matériel source peut prendre plusieurs minutes. Et il vaut mieux ne pas exécuter 4K sur un ordinateur portable faible - commencez par 720p, voyez le résultat, puis augmentez la résolution.
Développement du personnage : deux erreurs qui tuent le résultat
La deuxième technique de la même vidéo est le développement correct du personnage. Il s'agit d'une image où le visage et les vêtements sont montrés séparément. Cela dépend de la manière dont il est assemblé si le visage flottera dans la génération ou restera en place.
Première erreur : le visage et les vêtements sont dessinés à des échelles différentes. Le mannequin ne comprend pas qu'il s'agit d'une seule personne et commence à compléter elle-même les proportions. Deuxième erreur : le scan est assemblé à partir de morceaux de personnes différentes - le résultat est alors un visage extraterrestre moyenné et le filtre fonctionne à nouveau.
L'option de travail est un scan, une personne, la même lumière et le même angle sur les deux parties.
Si la génération échoue toujours avec une erreur concernant une personne reconnaissable
Il arrive que la carte de profondeur soit en place, le scan soit assemblé correctement, mais Seedance refuse toujours. Cela signifie que le problème réside dans l’une des images et que nous devons le trouver.
La méthode est simple : la méthode d’élimination. Vous supprimez les références une à une et recommencez. Dès que la génération passe, la dernière image supprimée est à blâmer. Ensuite, soit vous le reconstruisez, soit vous le remplacez par une carte de profondeur.
Pendant longtemps? Oui. Mais sans deviner : en trois ou quatre passages, vous pouvez voir la raison exacte.
Et la deuxième technique de la même vidéo : une grille régulière est appliquée sur l'image coupable - même des carrés sur le visage. Le filtre ne voit plus l'ensemble du visage, mais pour la génération les traits restent lisibles. La grille est placée dans n'importe quel éditeur ou il est simplement demandé au réseau de neurones de « mettre une grille carrée sur cette photo ».
Transférer le mouvement de la caméra depuis n'importe quel film
La même technique fonctionne sans remplacer le visage. Vous prenez une image d'un film, en faites une carte de profondeur, la donnez au modèle avec votre invite - et vous obtenez votre scène avec le même mouvement de caméra : la même approche, le même virage, le même rythme.
C'est ainsi que sont tournées des bandes-annonces, des parodies et des publicités lorsqu'un tour « cinématographique » est nécessaire, mais il n'y a pas de budget pour un caméraman avec une grue.
Quelle est la prochaine étape
L'ordre est le suivant : d'abord la carte de profondeur - gratuit dans le navigateur, sans télécharger de fichier et sans radier de jetons. Puis la génération elle-même - Seedance 2.5 sur notre site internet, il y a aussi un développement de personnage et des références.
Si quelque chose ne fonctionne pas du premier coup, commencez par un court clip de 3 à 5 secondes. Il montre à la fois les mouvements de la caméra et le comportement du visage, et prend beaucoup moins de temps et de jetons.