Kuka puhui milloin ilmaiseksi: äänierottelu ja suorat tekstitykset
Tapaamisen, haastattelun tai luennon jälkeen jää tallenne, jossa useat ihmiset puhuvat, eikä tavallinen transkriptio voi kertoa kuka sanoi mitä. Kuka puhui milloin on ilmainen selaintyökalu: se jakaa tallenteen kaiuttimiin (enintään neljään), muuttaa puheen valinnaisesti aikaleimatuksi dialogiksi ja sen toinen välilehti lähettää livetekstitykset suoraan mikrofonistasi. Tiedostoa ei koskaan ladata, tokeneja ei käytetä eikä tiliä tarvita.
Miten se toimii
Kaiuttimien erottelu toimii mallilla NVIDIA Sortformer: se löytää jopa neljä puhujaa ja määrittää ajanjaksot, jolloin kukin niistä on kuultu. Jos jätät "Litteroi myös puhe" -ruudun valituksi, sanat liittyvät puhujiin – saat dialogin tekstin, jossa on merkintä "Speaker 1", "Speaker 2" ja edelleen, jonka voit kopioida tai ladata muodossa TXT, SRT, VTT tai JSON. Aikajanan vieressä oleva merkki osoittaa, kuinka monta puhujaa malli löysi.
Ensimmäinen ajo lataa mallipainot laitteellesi – yhteensä noin 380 Mt. Sen jälkeen ne pysyvät välimuistissa selaimessasi, eivätkä myöhemmät suoritukset tarvitse verkkoa. Näytönohjaimella (WebGPU) analyysi on nopeaa; ilman sitä moottori putoaa takaisin prosessorille (WASM) - huomattavasti hitaammin, mutta tulos on sama, ja työkalu kertoo sinulle, kun se tapahtuu. Ääni on taitettu 16 kHz monoksi selaimessa; mitään ei tarvitse äänittää missään.
Oman tallenteen merkitseminen
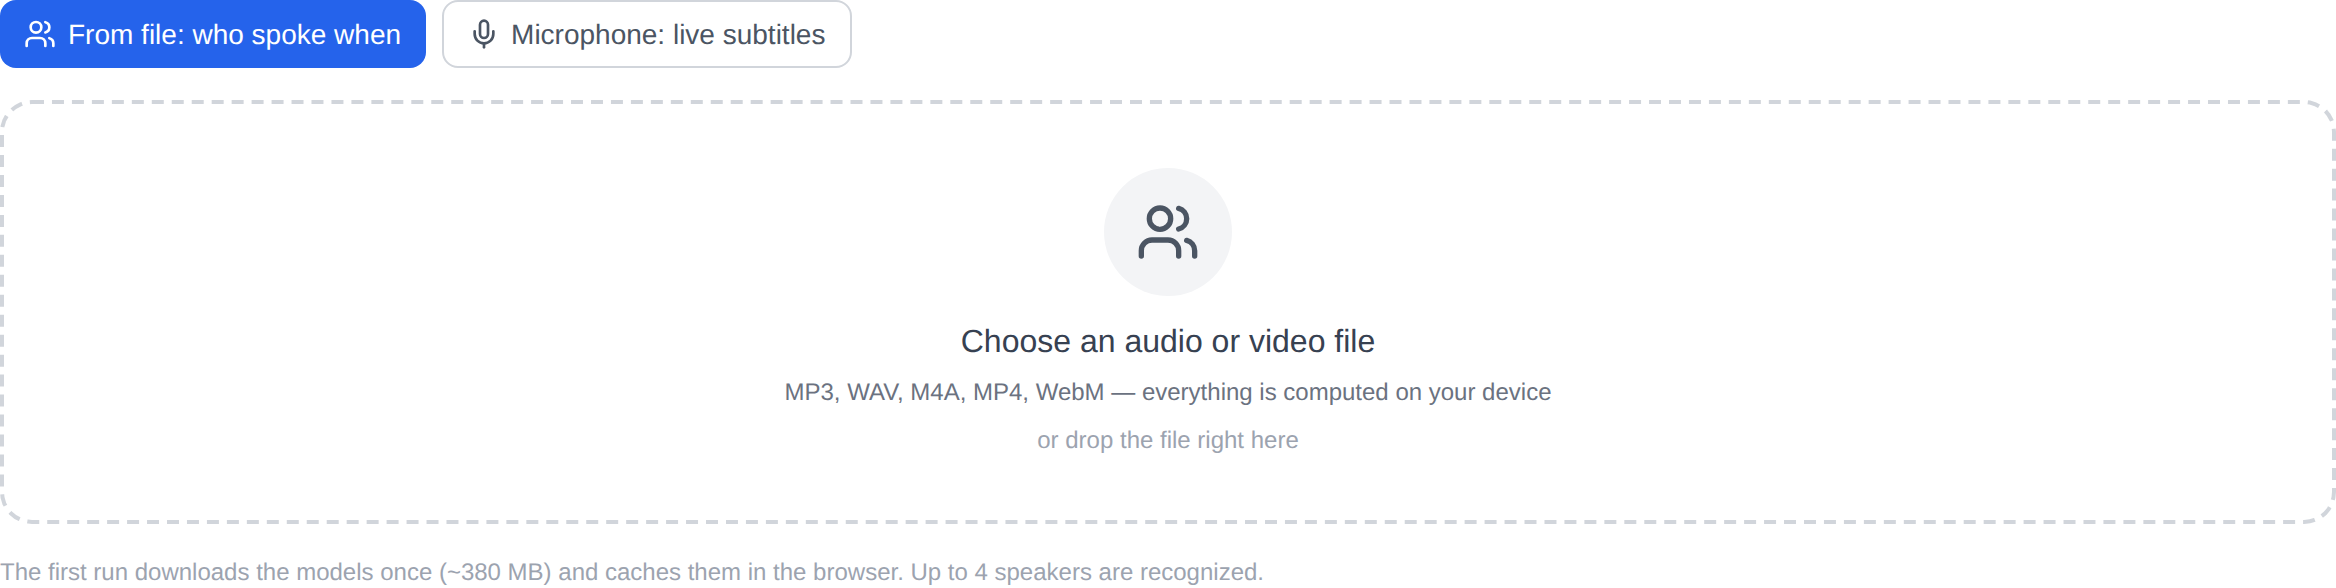
- Avaa työkalu ja valitse ääni- tai videotiedosto: MP3, WAV, M4A, MP4 ja WebM hyväksytään, ja voit pudottaa tiedoston kehykseen.
- Valitse "Literoi myös puhe" -ruutu: valittuna, se antaa sinulle aikaleimatun dialogin; ei ole valittuna, vain "kuka ja milloin puhui" -aikajana.
- Paina käynnistyspainiketta. Odota ensimmäisellä kerralla, että mallit latautuvat – edistymispalkki pitää sinut ajan tasalla.
- Tuloksena on aikajana ja dialogi. Kopioi teksti painikkeella tai lataa se tarvitsemassasi muodossa.
Livetekstitykset mikrofonista
Toinen välilehti ottaa äänen suoraan mikrofonista ja tekstittää sen lause kerrallaan puhuessasi: nykyinen lause näkyy suurina, valmiit jäävät alla olevaan luetteloon. Se sopii kokoukseen, luennolle tai videopuheluun, kun tekstityksiä tarvitaan nyt eikä tiedoston käsittelyn jälkeen. Mikrofonin pääsyä pyydetään painamalla painiketta; mitään ei kirjoiteta tiedostoon eikä mitään poistu selaimesta.
Mitä tietää etukäteen
Työkalu on nuori ja kokeellinen: erotuksen laatu riippuu tallenteesta. Puhtaat mikrofonikeskustelut jakautuvat luottavaisesti, kun taas meluisat, kaikuvat tallenteet ja jatkuvat keskeytykset voivat hämmentää sen. Puhetyö vie myös muistia – varaa noin 1 Gt päätilaa. Prosessoripolulla (WASM) pitkä tallennus kestää huomattavasti kauemmin kuin näytönohjain. Malli ei opi nimiä: "Speaker 1" ja "Speaker 2" -tarrat on tarkoitus nimetä uudelleen viennin jälkeen vastaamaan minuuttejasi.
Kuka sitä tarvitsee
Toimittaja löytää nopeasti, missä haastattelussa uusi ääni tulee. Opiskelija voi asettaa luentotallenteen rivi riviltä: missä professori puhui ja missä yleisö kysyi. Podcast-editori voi paikantaa pitkän istunnon kohdat, joissa kaikki puhuivat keskenään, ja leikata ne pois. Kokoussihteeri voi tehdä pöytäkirjaluonnoksen aikakoodeilla lähettämättä tallennetta minnekään.
Kun tarvitset jotain muuta
Jos haluat pelkkää tekstiä äänierittelyn sijaan, avaa ääni ja video → teksti. Muut osion työkalut toimivat osoitteessa Audio sivulle, ja lisää ilmaisia paikallisia työkaluja on alla Muut työkalut. Analyysin tekee avoin kirjasto FluidAudio (lisenssi MIT): koodi ja mallit ovat selaimessasi ilman kiertoteitä muille palvelimille.