Quién habló cuándo gratis: separación de voces y subtítulos en directo
Después de una reunión, una entrevista o una conferencia, te quedas con una grabación en la que varias personas hablan, y una transcripción normal no puede decirte quién dijo qué. ¿Quién habló cuando? es una herramienta de navegador gratuita: divide la grabación en oradores (hasta cuatro), opcionalmente convierte el discurso en un diálogo con marca de tiempo y su segunda pestaña ejecuta subtítulos en vivo directamente desde su micrófono. El archivo nunca se carga, no se gastan tokens y no se necesita ninguna cuenta.
como funciona
La separación de altavoces se basa en el modelo NVIDIA Sortformer: encuentra hasta cuatro altavoces y establece los períodos de tiempo en los que se escuchó a cada uno de ellos. Si deja marcada la casilla "Transcribir también el discurso", las palabras se adjuntan a los oradores; obtendrá una transcripción del diálogo denominada "Orador 1", "Orador 2" y siguientes, que puede copiar o descargar como TXT, SRT, VTT o JSON. Una insignia junto a la línea de tiempo muestra cuántos oradores encontró el modelo.
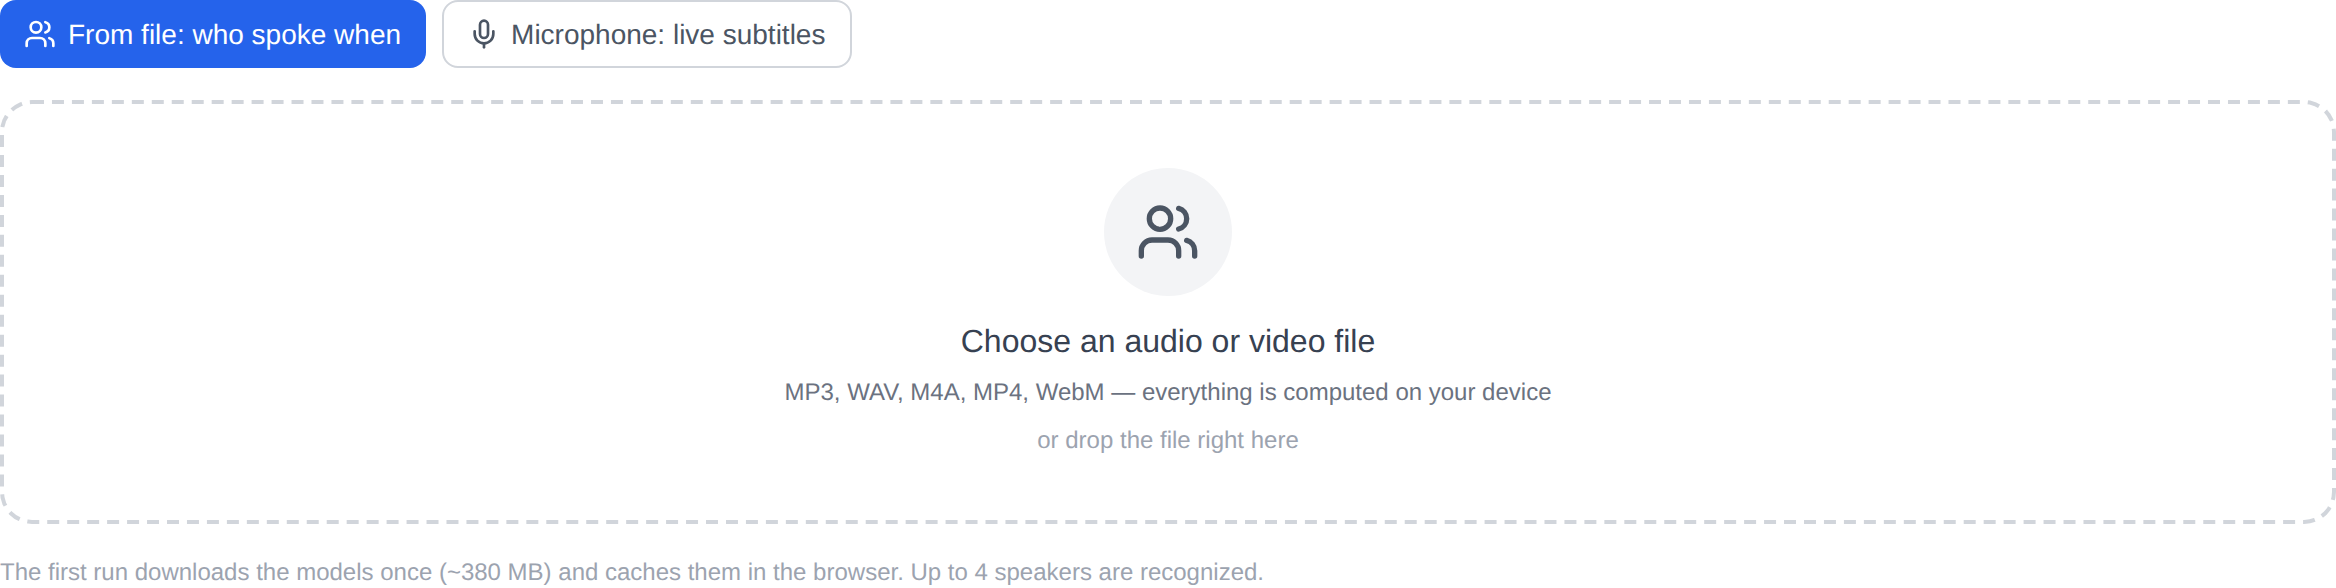
La primera ejecución descarga los pesos del modelo a su dispositivo: aproximadamente 380 MB en total. Después de eso, permanecen almacenados en caché en su navegador y las ejecuciones posteriores no necesitan red. Con una tarjeta gráfica (WebGPU) el análisis es rápido; sin él, el motor vuelve al procesador (WASM): notablemente más lento, pero el resultado es el mismo y la herramienta le avisará cuando eso suceda. El audio se reduce a 16 kHz mono dentro del navegador; No es necesario grabar nada en ningún lado.
Marcar tu propia grabación
- Abre el herramienta y elija un archivo de audio o video: se aceptan MP3, WAV, M4A, MP4 y WebM, y puede colocar el archivo en el marco.
- Elija la casilla “Transcribir también el discurso”: marcada, le proporciona un diálogo con marca de tiempo; sin marcar, solo la línea de tiempo de “quién y cuándo habló”.
- Presione el botón de inicio. En la primera ejecución, espere a que se descarguen los modelos; la barra de progreso lo mantendrá informado.
- El resultado es la línea de tiempo más el diálogo. Copia el texto con un botón o descárgalo en el formato que necesites.
Subtítulos en vivo desde el micrófono
La segunda pestaña toma el sonido directamente del micrófono y lo subtitula frase por frase mientras habla: la frase actual aparece en grande, las terminadas permanecen en la lista a continuación. Es adecuado para una reunión, una conferencia o una videollamada, cuando los subtítulos se necesitan ahora y no después de procesar un archivo. El acceso al micrófono se solicita presionando el botón; no se escribe nada en un archivo y nada sale del navegador.
Que saber de antemano
La herramienta es joven y experimental: la calidad de la separación depende de la grabación. Las conversaciones con un micrófono limpio se dividen con confianza, mientras que las grabaciones ruidosas y con eco con interrupciones constantes pueden confundirlo. El trabajo del habla también requiere memoria: planifique alrededor de 1 GB de espacio libre. En la ruta del procesador (WASM) una grabación larga tarda notablemente más que en una tarjeta gráfica. El modelo no aprende nombres: las etiquetas "Orador 1" y "Orador 2" deben cambiarse de nombre después de la exportación, para que coincidan con sus minutos.
quien lo necesita
Un periodista puede encontrar rápidamente dónde entra una nueva voz en una entrevista. Un estudiante puede registrar una conferencia línea por línea: dónde habló el profesor y dónde preguntó el público. Un editor de podcasts puede localizar los tramos de una sesión larga en los que todos hablaron entre sí y recortarlos. Un secretario de reuniones puede crear un borrador de las actas con códigos de tiempo sin enviar la grabación a ninguna parte.
Cuando necesitas algo más
Si lo que quieres es texto plano en lugar de un desglose por voz, abre audio y vídeo → texto. Las otras herramientas de la sección viven en el Audio página, y hay más herramientas locales gratuitas en Otras herramientas. El análisis se realiza mediante la biblioteca abierta FluidAudio (licencia MIT): el código y los modelos viven en su navegador, sin desvíos a otros servidores.