Un orbe de voz que realmente controla el sitio: la arquitectura de un asistente, no una “Pregunta frecuente parlante”
Brevemente sobre lo principal (BLUF)
Un widget parlante en un sitio web no es un asistente, sino un juguete: habla pero no hace nada. Nuestro orbe de voz realmente dirige el sitio. En su interior hay tres capas de arquitectura, tres rastrillos que pisamos, la economía del diálogo y una manera de poner el mismo orbe en su sitio web.
Los asistentes de voz en los sitios web generalmente terminan en una de dos maneras: o es un chatbot con reconocimiento de voz adjunto o es una voz en off de preguntas frecuentes. estamos en NeuralSpace Pasó de la tarea inversa: hacer una voz. la forma principal de gestionar la interfaz, y no una superestructura sobre el texto. A continuación se muestra un análisis de la arquitectura y las decisiones que hubo que tomar.
Tarea
El usuario abre una página de generación compleja: video, fotos, música — donde se puede elegir el modelo, cargar una referencia, una solicitud, parámetros. El recién llegado está perdido. La gente cierra el clásico onboarding (recorrido con flechas) en el segundo paso. Queríamos que fuera posible simplemente decir con una voz: “Quiero darle vida a esta foto”, y el propio asistente resaltó el botón deseado, lo explicó y lo llevó al resultado.
Diferencia clave con un chatbot: orbe ve el estado de la página Y actúa sobre ella, en lugar de responder con el texto "presiona el botón X en algún lugar de allí".
Arquitectura: tres capas
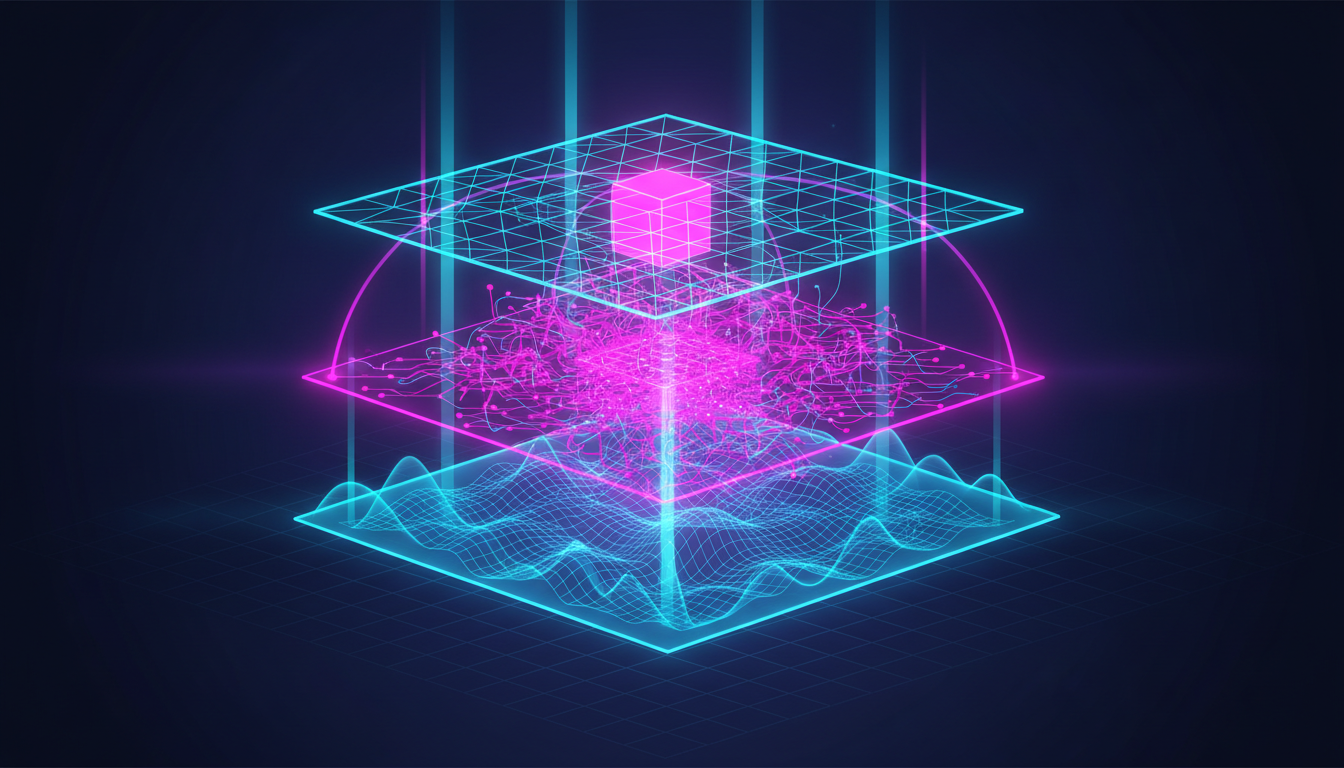
- Tracto vocal. Streaming de reconocimiento de voz → modelo → síntesis de respuesta. El requisito es una baja latencia y la capacidad interrumpir (irrupción): el usuario comienza a hablar, el asistente se queda en silencio. Sin esto, el diálogo se siente más como un walkie-talkie que como una conversación.
- Cerebro. Desacoplamos deliberadamente la "personalidad" del asistente de un modelo de lenguaje específico: el modelo está configurado en el lado del servidor, por lo que se puede cambiar para adaptarse a la tarea y al costo sin volver a desarrollar la interfaz. El asistente recibe no sólo la respuesta del usuario, sino también instantánea legible por máquina de la página actual: qué elementos hay, qué botones, qué ya está seleccionado.
- Ejecutor del cliente. El modelo devuelve no sólo texto, sino también comportamiento: resaltar elemento, desplazarse hasta bloquear, explicar campo. El cliente los ejecuta sobre el DOM real.
Tres rastrillos que pisamos
Lo más interesante no es el camino feliz, sino los fracasos. Analizamos los registros de diálogos reales y creamos las reglas raíz.
1. Alucinación de posibilidades. El asistente sugirió modelos que no estaban en la página actual, o confundió el modelo para imágenes con el modelo para video. El usuario está enfadado con razón: “no existe tal modelo”. Solución: no confíe en el “conocimiento del mundo” del modelo: el asistente puede nombrar y cambiar solo lo que está realmente en la instantánea de la página actual. Este es un problema de conexión a tierra clásico: el modelo debe estar estrictamente vinculado al estado de la interfaz; de lo contrario, mentirá con seguridad.
2. Se ilumina el botón equivocado. Te piden que muestres "subir una foto"; "Generar" está resaltado. La razón es el mapeo difuso “intención → elemento”. Solución: los elementos reciben anclajes semánticos y el asistente debe resaltar exactamente ese, del que habla, y no vecino en significado.
3. Obsesión. El modelo ya ha sido seleccionado; el asistente todavía intenta cambiarlo; el usuario pregunta "simplemente escriba una solicitud", y él argumenta. Regla: si el estado ya es adecuado o el usuario pide explícitamente no tocar - no actúes ni discutas, haga inmediatamente lo que se le pide. Menos iniciativa, más ejecución.
La conclusión que le daríamos a cualquiera que cree un agente sobre una interfaz es: El 90% de la calidad no es un modelo, sino fundamento y disciplina de acción.. El modelo debe ver el estado exacto y no se le permite ir más allá.
Economía del diálogo
La voz es más cara que el texto, por lo que Orb tiene una ventana gratuita y luego el pago se realiza al momento de la conversación. La facturación está ligada a la duración de la interacción de voz, no a la cantidad de "mensajes".
El mismo orbe está en su sitio web.
Personalizamos el orbe nosotros mismos, pero la tarea es universal: cualquier sitio con una interfaz no trivial (configurador, cuenta personal, formulario complejo, tienda con filtros) se beneficia de una guía de voz que ve la página y actúa en consecuencia. Por lo tanto, lo colocamos en un widget integrado; cómo se instala y qué puede hacer se analiza por separado: agente de voz para cualquier sitio web.
Si está haciendo algo similar, es interesante comparar los enfoques de puesta a tierra e irrupción. Puedes probar Orb en vivo en neuralspace.pro.
Preguntas frecuentes (FAQ)
Pregunta: ¿Cómo obtener el mejor resultado de una red neuronal?
Respuesta: Utilice indicaciones detalladas (descripciones) en inglés, establezca el estilo y los detalles de la escena.
Pregunta: ¿Se pueden utilizar estos materiales con fines comerciales?
Respuesta: Sí, el contenido generado es totalmente tuyo.