Wer hat wann kostenlos gesprochen: Stimmtrennung und Untertitel
Jede Aufnahme mit mehr als einer Stimme lässt Sie mit der gleichen Frage zurück: „Wer hat das gesagt?“. Wer hat wann gesprochen (kostenlos) beantwortet die Frage direkt in Ihrem Browser: Das Tool findet, wo Zeilen beginnen und enden, sortiert sie nach Sprecher – „Sprecher 1“, „Sprecher 2“ usw., bis zu vier Personen – und fügt, wenn Sie möchten, auch den Text hinzu. Die Datei wird nie hochgeladen, es werden keine Tokens berechnet und es ist kein Konto erforderlich.
So funktioniert die Lautsprechertrennung
Die Aufgabe wird Diarisierung genannt: Das Modell hört sich den gesamten Stream an und beantwortet zwei Fragen getrennt – wer hat gesprochen und in welchen Minuten. Stimmen werden nach Klangfarbe verglichen, sodass Zeilen derselben Person auf einer Spur landen, auch wenn die Leute übereinander reden. Was Sie zurückerhalten, ist eine Zeitleiste: Jede Zeile ist eine Redezeile mit eigenen Zeitstempeln und einer Sprecherbezeichnung.
Alles wird auf Ihrem Gerät berechnet. Die Modelle werden einmal in Ihren Browser heruntergeladen und funktionieren dann offline. Auf einer Grafikkarte über WebGPU läuft die Analyse spürbar schneller, und wenn der Browser keine hergibt, greift sie über WASM auf den Prozessor zurück – richtig, aber langsam. Überprüfen Sie vor einer längeren Aufnahme den Speicherhinweis: Die Modelle benötigen etwa ein Gigabyte, um komfortabel zu laufen.
Eine Datei Schritt für Schritt analysieren
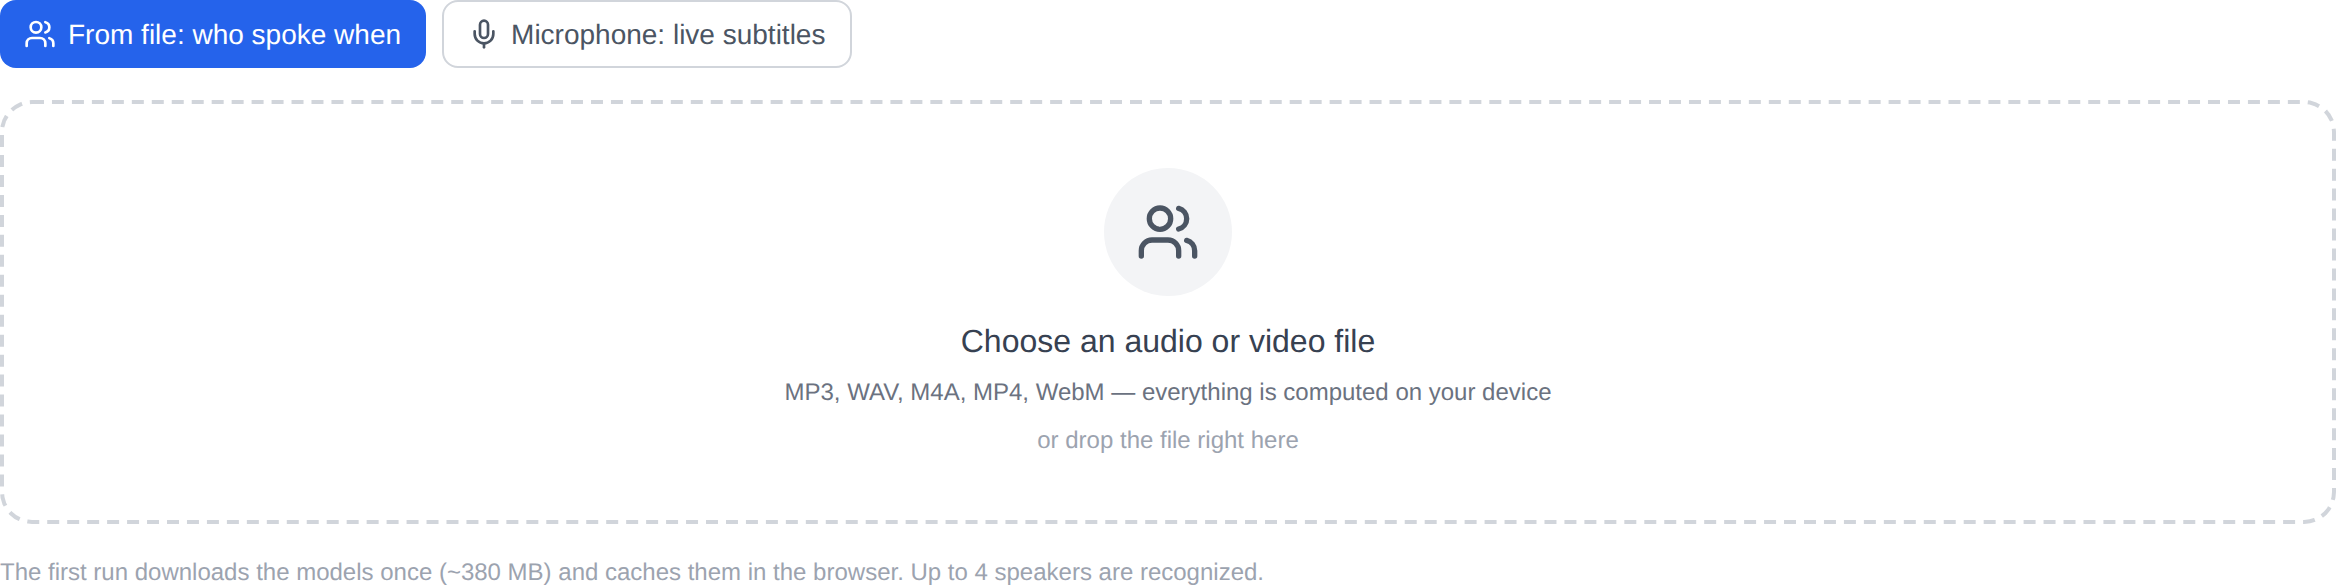
- Öffnen Sie die Werkzeug und wählen Sie auf der Registerkarte „Datei“ eine Aufnahme aus: MP3, WAV, M4A, MP4, WebM und andere Mediendateien werden akzeptiert.
- Mit der Checkbox „Auch die Rede transkribieren“ wird das Textmodell aktiviert: Wörter werden auf die Sprecherspuren gelegt und zu einem lesbaren Dialog zusammengesetzt. Wenn diese Option deaktiviert ist, teilt das Tool die Aufnahme nur nach Stimmen auf, was schneller ist.
- Beim ersten Durchlauf werden die Modelle heruntergeladen (ca. 380 MB) und zwischengespeichert. Die nächsten Analysen beginnen sofort.
- Warten Sie auf die Zeitleiste und den Dialog und kopieren Sie dann das Ergebnis oder exportieren Sie es als TXT, SRT, VTT oder JSON. In den Untertiteln SRT und VTT trägt jede Zeile den Namen des Sprechers, sodass die Datei direkt in einen Videoeditor eingefügt wird.
Live-Untertitel vom Mikrofon
Für die zweite Registerkarte ist keine Datei erforderlich: Schalten Sie Ihr Mikrofon ein und während Sie sprechen, werden Phrasen auf dem Bildschirm angezeigt. Eine fertige Phrase wird mit einem Zeitstempel in die Liste verschoben, während sich die nächste darunter eintippt. Der Ton wird nicht aufgezeichnet und nicht an einen Server gesendet – die Untertitel sind nur auf Ihrer Seite verfügbar, und Sie können dies jederzeit über die Registerkarte „Netzwerk“ in Ihren Entwicklertools überprüfen. Es eignet sich für Anrufe, Besprechungen und Vorträge, bei denen Sie das Transkript noch während des Gesprächs benötigen, nicht danach.
Ehrliche Grenzen
Dies ist ein Tool zur Sprechertrennung, kein universeller Transkribierer. Das Spracherkennungsmodell wurde hauptsächlich auf Englisch trainiert: Es transkribiert ein Gespräch in einer anderen Sprache, jedoch mit deutlich mehr Fehlern als auf Englisch. Bis zu vier Lautsprecher werden zuverlässig getrennt; Eine Aufnahme aus einem lauten Saal mit Unterbrechungen ist deutlich schlimmer als ein ruhiges Interview. Ein Transkript mit Sprechernamen ist keine professionelle Transkription. Lesen Sie es daher noch einmal durch, bevor Sie es weitergeben.
Die Hardware ist die andere Grenze: Ein schwaches Gerät verfügt möglicherweise nicht über genügend Speicher für die Modelle, und die reine Prozessoranalyse dauert eine Weile. Im Gegenzug ist der Preis auf nichts festgelegt: keine Warteschlangen, keine Gebühren, keine Uploads.
Wem es passt
Ein Journalist kann die Struktur eines Interviews sehen und in wenigen Minuten Zitate herauslesen. Ein Meeting-Gastgeber kann eine „Wer hat was gesagt?“-Aufzeichnung erhalten, ohne das Band durchsuchen zu müssen. Ein Videoeditor kann über SRT oder VTT Untertitel mit Sprechernamen in ein Projekt einfügen. Ein Student kann eine Vorlesung in Zeilen und Gesprächsthemen unterteilen.
Wenn Sie Texte ohne Sprechertrennung und in vielen Sprachen benötigen, Spracherkennung (kostenlos) läuft nebenher. Der Rest des Abschnitts lebt auf der Audio Auf dieser Seite finden Sie kostenlose lokale Tools Andere Tools. Beginnen Sie mit einer kurzen fünfminütigen Aufzeichnung: Ein erster Durchlauf mit dem Modell-Download reicht aus, um zu hören, wie Ihre Aufzeichnungen die Analyse überstehen.