Dybdekort for Seedance 2.5: hvordan man omgår ansigtsblokering
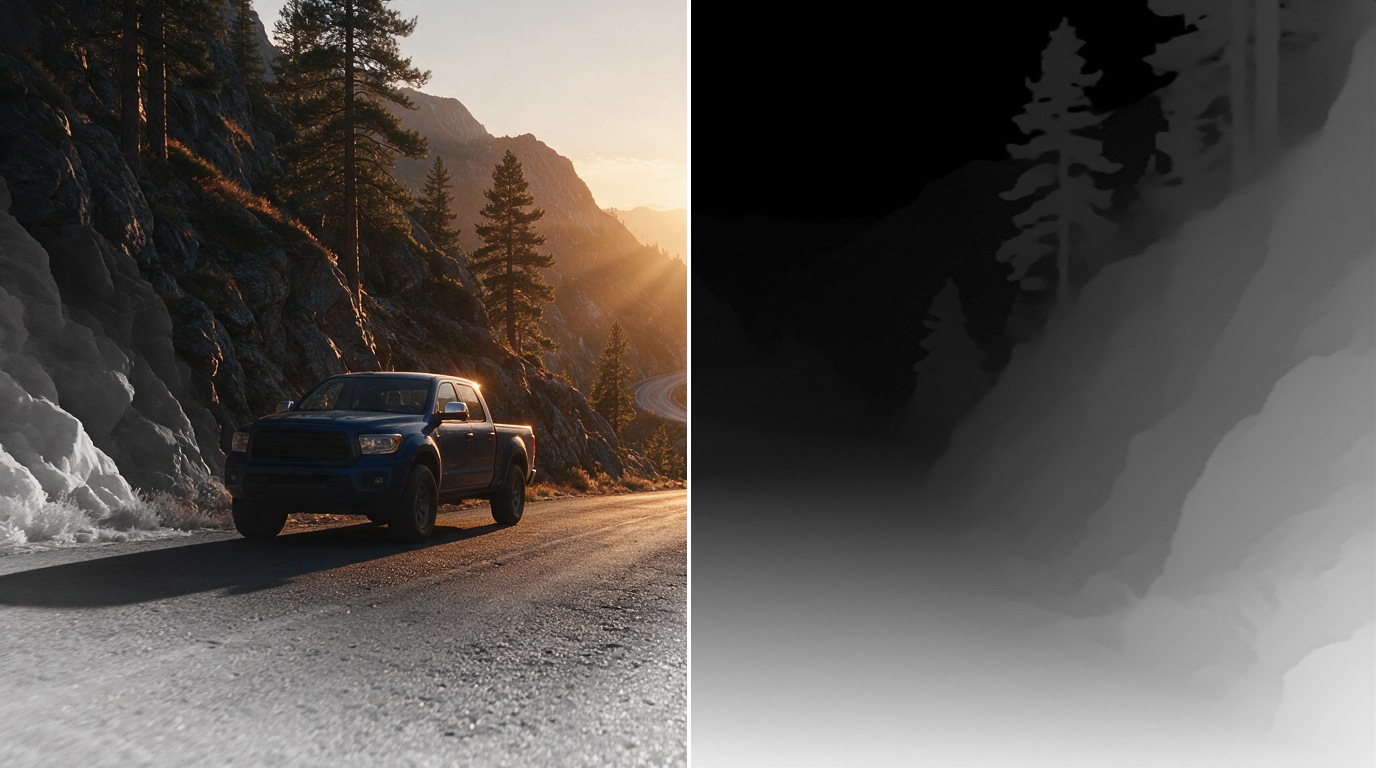
Seedance 2.5 nægter at arbejde, hvis der er et genkendeligt ansigt eller et stykke af en andens film i rammen. Sådan kæmper virksomheden mod forfalskninger af berømtheder, men det kommer til almindelige mennesker: En model afviser nogle gange endda din egen selfie. Der er en løsning, og det handler ikke om hacking. Modellen passerer nemt gennem dybdekortet – et sort/hvidt billede, hvor lysstyrken viser afstanden til kameraet. Der er ingen ansigter på den, kun scenens geometri. Nedenfor kan du se, hvordan du laver sådan et kort fra din video gratis, lige i browseren, og hvad du skal gøre, hvis generationen stadig falder.
Hvorfor ser en model en berømthed, hvor der ikke er nogen?
Filtre Seedance er trænet på ansigter. Deres opgave er enkel: at forhindre udseendet af en berømt person i at blive forfalsket. Problemet er, at de definerer "berømmelse" ved ansigtets geometri, og ikke ved navnet i krediteringerne. En lignende øjenform, den samme hageform - og det er det, afslag.
Det er endnu nemmere med filmoptagelser: ophavsretsbeskyttelse virker der. Modellen genkender scenen og savner den ikke helt, selvom du bare vil gentage kamerabevægelsen.
Resultat: to forskellige forbud, men det ser ens ud - en rød fejl og spild af tid.
Dybdekort: geometri i stedet for ansigter
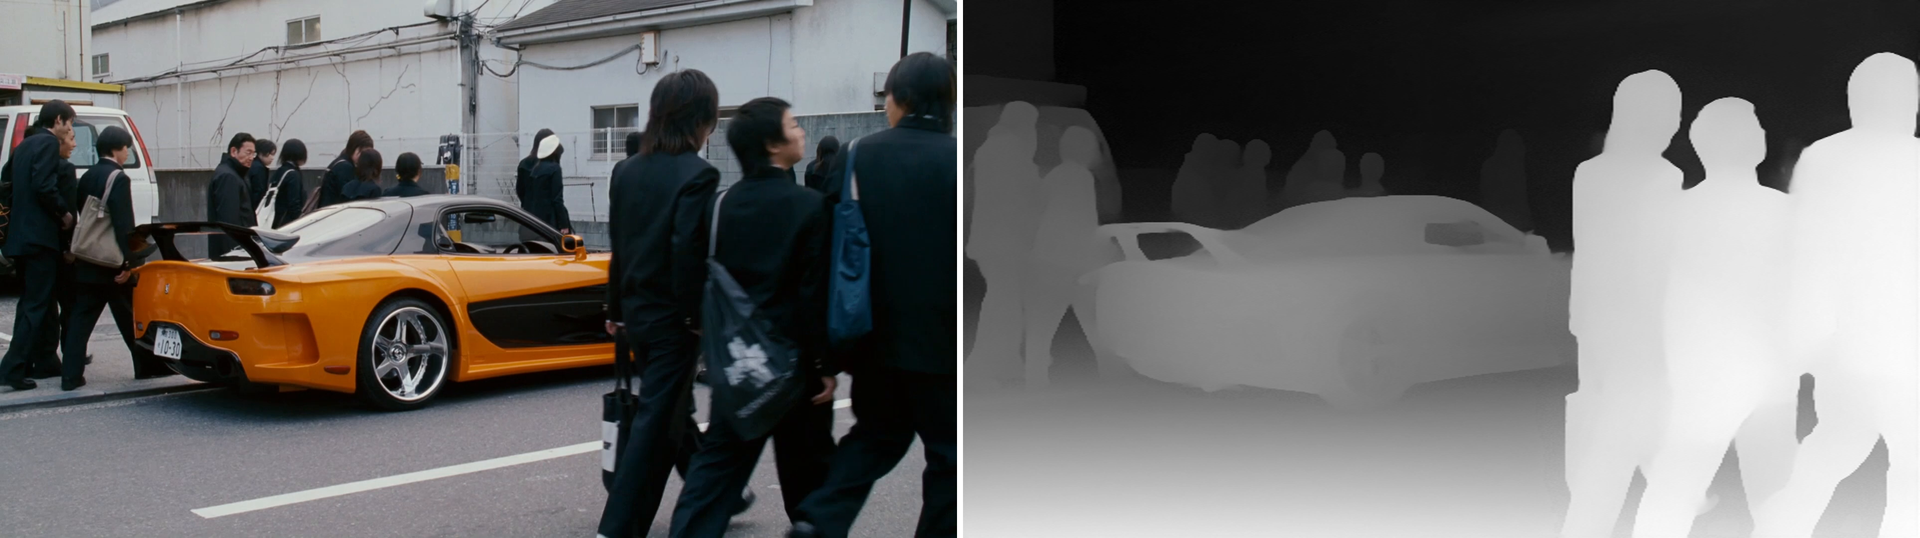
Et dybdekort er den samme video, kun gentegnet i gråtoner. Jo tættere objektet er på kameraet, jo lysere er pixlen. Baggrunden falmer til sort, baggrunden til hvid. Ingen teksturer, ingen hud, ingen øjne: det eneste, der er tilbage, er relieffet fra scenen.
Dette er et nøglepunkt for filteret. Der er intet at tjekke - der er ingen ansigter. Og for generation er der alt, hvad du behøver: hvor objekterne var, hvor kameraet skulle hen, hvordan planen ændrede sig. Vi kopierer ikke en andens ramme, vi tager bevægelsen og arrangementet fra den, og modellen tegner sit eget billede, fra bunden.
Ærligt om begrænsningen: det er ikke en "omgå alt-knap." Hvis du prompte spørger direkte til en bestemt skuespillers ansigt, kommer afslaget igen. Dybdekortet løser problemet med geometri og bevægelse, ikke personlighedssubstitution.
Sådan laver du et dybdekort fra en video - gratis og uden upload til serveren
På vores hjemmeside er dette en separat model i videosektionen: Dybdekort (gratis). Det er på listen over modeller under MiniMax. Du vælger en video, trykker på en knap, og alt bliver beregnet på din enhed.
Hvad er inde i: model Depth Anything V2 Small (licens Apache 2.0) afspiller direkte i browseren via ONNX Runtime Web. Hvis du har WebGPU, tæller videokortet, hvis ikke, fungerer backupstien på processoren. Frames parses gennem WebCodecs og samles derefter tilbage til video med den originale FPS og den maksimale opløsning, som din browser kan håndtere.
Outputtet er MP4 eller WebM - hvad browseren understøtter. Der er en forhåndsvisning af resultatet, en kontakt "Tættere - lysere / Tættere - mørkere" og paletter: grå nuancer, Inferno, Viridis. Behandlingsfremskridt er synligt billede for billede; lang behandling kan annulleres.
To ting, der betyder mest. For det første: filen går ingen steder - hverken til vores server eller til en andens, alt arbejde foregår på enheden. For det andet: tokens afskrives ikke for dette; der er ingen betalt API i denne model overhovedet. Modelvægtene og motorfilerne gemmes i browseren, så siden starter hurtigere op anden gang.
Hvor det vil være ubehageligt. Du skal bruge Chrome eller Edge - WebCodecs er ikke tilgængelig alle steder. En lang video på en processor betragtes ikke som hurtig: Et minuts kildemateriale kan tage flere minutter. Og det er bedre ikke at køre 4K på en svag bærbar computer - start med 720p, se resultatet, og hæv derefter opløsningen.
Karakterudvikling: to fejl, der dræber resultatet
Den anden teknik fra samme video er den korrekte udvikling af karakteren. Dette er et billede, hvor ansigtet og tøjet vises separat. Det afhænger af, hvordan det er samlet, om ansigtet vil flyde i generationen eller forblive på plads.
Den første fejl: ansigtet og tøjet er tegnet i forskellige skalaer. Modellen forstår ikke, at dette er en person, og begynder selv at fuldføre proportionerne. Fejl to: scanningen er samlet af stykker af forskellige mennesker - så er outputtet et gennemsnitligt alien-ansigt, og filteret virker igen.
Arbejdsmuligheden er én scanning, én person, samme lys og vinkel på begge dele.
Hvis generationen alligevel fejler med en fejl om en genkendelig person
Det sker, at dybdekortet er på plads, scanningen er samlet korrekt, men Seedance afviser stadig. Det betyder, at problemet er på et af billederne, og vi skal finde det.
Metoden er enkel - metoden til eliminering. Du fjerner referencerne én efter én og starter forfra. Så snart generationen går, var det sidste fjernede billede skylden. Så bygger du det enten om eller erstatter det med et dybdekort.
I lang tid? Ja. Men uden at gætte: I tre eller fire løb kan du se den nøjagtige årsag.
Og den anden teknik fra den samme video: et almindeligt gitter påføres det skyldige billede - endda firkanter over ansigtet. Filteret holder op med at se hele ansigtet, men i generation forbliver funktionerne læsbare. Gitteret placeres i en hvilken som helst editor, eller det neurale netværk bliver simpelthen bedt om at "sætte et firkantet gitter på dette billede."
Overfør kamerabevægelser fra enhver film
Den samme teknik virker uden at erstatte ansigtet. Du tager et billede fra en film, laver et dybdekort af det, giver det til modellen sammen med din prompt – og du får din scene med samme kamerabevægelse: samme tilgang, samme drejning, samme rytme.
Sådan optages trailere, parodier og reklamer, når der er brug for en "filmisk" tur, men der er ikke budget for en kameramand med kran.
Hvad er det næste
Rækkefølgen er som følger: først dybdekortet - gratis i browseren, uden at downloade en fil og uden at afskrive tokens. Så selve generationen - Seedance 2.5 på vores hjemmeside, der er også en karakterudvikling og referencer.
Hvis noget ikke virker første gang, så start med et kort klip på 3-5 sekunder. Det viser både kamerabevægelser og ansigtsadfærd og tager meget mindre tid og tokens.