Kdo kdy mluvil zdarma: hlasové oddělení a živé titulky
Po schůzce, rozhovoru nebo přednášce vám zůstane nahrávka, kde mluví několik lidí, a běžný přepis vám neřekne, kdo co řekl. Kdo kdy mluvil je bezplatný nástroj prohlížeče: rozdělí nahrávku na reproduktory (až čtyři), volitelně změní řeč na dialog s časovým razítkem a na druhé kartě se spouští živé titulky přímo z vašeho mikrofonu. Soubor se nikdy nenahraje, neutratí se žádné tokeny a není potřeba žádný účet.
Jak to funguje
Oddělení reproduktorů je poháněno modelem NVIDIA Sortformer: najde až čtyři reproduktory a rozloží časové úseky, ve kterých byl každý slyšet. Pokud necháte zaškrtnuté políčko „Také přepsat řeč“, slova se připojí k mluvčím — získáte přepis dialogu označený jako „Speaker 1“, „Speaker 2“ a dále, který můžete zkopírovat nebo stáhnout jako TXT, SRT, VTT nebo JSON. Odznak vedle časové osy ukazuje, kolik reproduktorů model našel.
První spuštění stáhne váhy modelu do vašeho zařízení – celkem asi 380 MB. Poté zůstanou uloženy v mezipaměti ve vašem prohlížeči a pozdější běhy nevyžadují žádnou síť. S grafickou kartou (WebGPU) je analýza rychlá; bez něj motor spadne zpět k procesoru (WASM) — znatelně pomalejší, ale výsledek je stejný a nástroj vám řekne, kdy k tomu dojde. Zvuk je v prohlížeči složen na 16 kHz mono; nic se nikde nemusí nahrávat.
Označení vlastní nahrávky
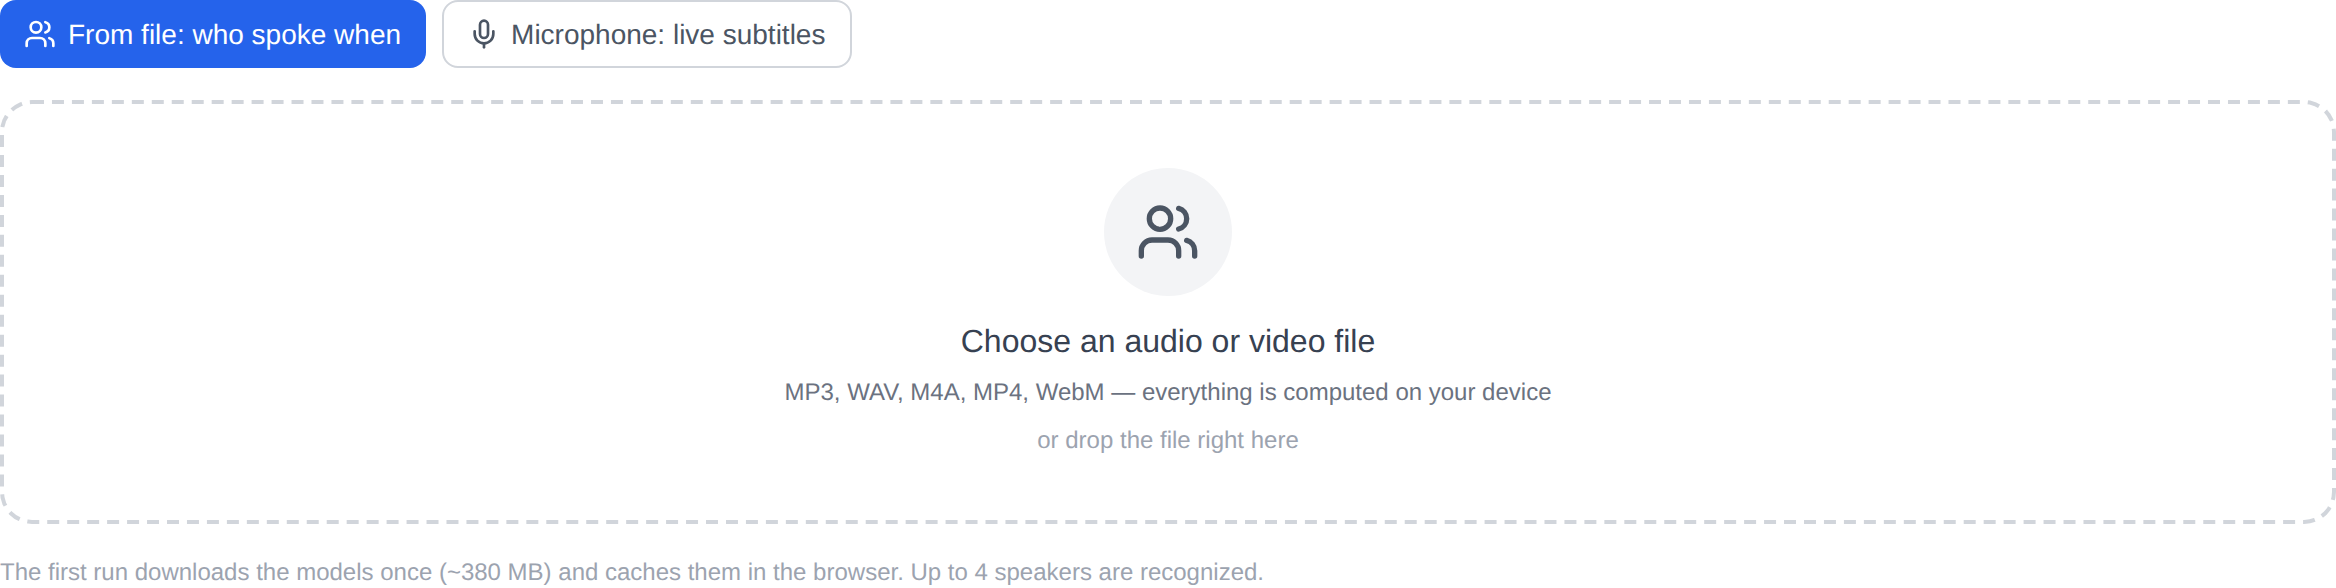
- Otevřete nástroj a vyberte audio nebo video soubor: MP3, WAV, M4A, MP4 a WebM jsou akceptovány a soubor můžete pustit do rámečku.
- Rozhodněte se pro políčko „Také přepsat řeč“: zaškrtnuto, zobrazí se vám dialog s časovým razítkem; nezaškrtnuto, pouze časová osa „kdo a kdy mluvil“.
- Stiskněte tlačítko start. Při prvním spuštění počkejte, až se modely stáhnou – ukazatel průběhu vás informuje.
- Výsledkem je časová osa plus dialog. Zkopírujte text pomocí tlačítka nebo si jej stáhněte ve formátu, který potřebujete.
Živé titulky z mikrofonu
Druhá záložka přebírá zvuk přímo z mikrofonu a popisuje ho frázi po frázi, když mluvíte: aktuální fráze se zobrazuje jako velká, hotové zůstávají v seznamu níže. Hodí se na schůzku, přednášku nebo videohovor, kdy jsou titulky potřeba hned, než po zpracování souboru. Přístup k mikrofonu je vyžadován stisknutím tlačítka; nic se nezapisuje do souboru a nic neopouští prohlížeč.
Co vědět předem
Nástroj je mladý a experimentální: kvalita separace závisí na nahrávce. Konverzace s čistým mikrofonem se sebevědomě rozdělují, zatímco hlučné, ozvěné nahrávky s neustálým přerušováním je mohou zmást. Práce s řečí také zabírá paměť — plánujte asi 1 GB volného prostoru. Na cestě procesoru (WASM) trvá dlouhý záznam znatelně déle než na grafické kartě. Model se neučí názvy: štítky „Speaker 1“ a „Speaker 2“ jsou po exportu určeny k přejmenování, aby odpovídaly vašim minutám.
Kdo to potřebuje
Novinář může rychle najít, kde nový hlas vstupuje do rozhovoru. Student může vyskládat záznam přednášky řádek po řádku: kde mluvil profesor a kde se ptalo publikum. Editor podcastů dokáže najít úseky dlouhého sezení, kde všichni mluvili jeden přes druhého, a vystřihnout je. Tajemník schůze může sestavit návrh zápisu s časovými kódy, aniž by nahrávku kamkoli posílal.
Když potřebujete něco jiného
Pokud chcete spíše prostý text než rozpis podle hlasu, otevřete audio a video → text. Ostatní nástroje sekce žijí na Zvuk a další bezplatné místní nástroje jsou pod Jiné nástroje. Analýza se provádí pomocí otevřené knihovny FluidAudio (licence MIT): kód a modely jsou uloženy ve vašem prohlížeči, bez odboček na jiné servery.