الذكاء الاصطناعي للفيديو: توليد من النص وتحريك الصور والدبلجة
يغطي الذكاء الاصطناعي للفيديو اليوم دورة إنتاج المحتوى المرئي بالكامل: إنشاء مقاطع سينمائية من الصفر عبر الأوامر النصية (Text-to-Video)، وتحويل الصور والرسومات الثابتة إلى مشاهد حركية حية (Image-to-Video)، وترجمة مقاطع الفيديو إلى لغات متعددة مع مزامنة دقيقة لحركة الشفاه (Lip-Sync). يضم قسم الفيديو في منصة NeuralSpace نخبة من أبرز النماذج العالمية، بما فيها عائلة SeeDance (2.5 و2.0 و1.5 Pro) ونماذج Kling 3.0 وGrok Video وVEO 3 وWan 2.6. نستعرض في هذا الدليل كيفية اختيار النموذج المناسب لكل مهمة، وصياغة الأوامر النصية للحصول على نتائج دقيقة، ومتطلبات الرندر الواقعية.
ثلاثة مسارات رئيسية لتوليد الفيديو
تجاوزت تقنيات الفيديو التوليدي مرحلة الرسوم التجريدية القصيرة، وأصبحت تعتمد على ثلاثة مسارات عملية:
- توليد الفيديو من النص (Text-to-Video). بناء مشاهد سينمائية كاملة وتصاميم إعلانية دون أي مواد مسبقة؛ حيث يتولى النموذج بناء الإضاءة والحركة وحركة الكاميرا بالكامل استناداً إلى الوصف المكتوب.
- تحريك الصور الثابتة (Image-to-Video). رفع صورة شخصية أو لقطة لمنتج وتوجيه النموذج لإضافة حركة انسيابية: تدفق المياه، أو حركة الرياح في الشعر، أو ابتسامة هادئة، مع الحفاظ الكامل على ملامح الأصل.
- الدبلجة ومزامنة الشفاه (Video-to-Video / Lip-Sync). ترجمة كلام المتحدث إلى لغات عالمية مختلفة مع إعادة رسم حركة الفم تلقائياً لتتطابق بدقة مع النطق الصوتي الجديد.
بيانات واقعية لسرعة الرندر والاستقرار على NeuralSpace
تتطلب معالجة الفيديو قدرات حوسبة متقدمة، وتختلف سرعة الرندر باختلاف نوع المهمة. وفقاً للبيانات المجمعة لمنصة NeuralSpace خلال آخر 90 يوماً (من 15 يوليو إلى 15 أكتوبر 2026، لعينة تضم 9,194 مهمة فيديو من سجل التوليد المجهل video_generations)، بلغت نسبة النجاح الإجمالية لتوليد المقاطع 69.1% (بإجمالي 6,357 مقطعاً مكتملاً).
وتوزعت مؤشرات السرعة والأداء كالتالي:
- تحريك الصور (Image-to-Video): المسار الأكثر استخداماً بواقع 3,384 مقطعاً ناجحاً، بمتوسط زمن رندر قدره 125.4 ثانية (نحو دقيقتين)، ما يجعله الأسرع لإنتاج المحتوى التفاعلي.
- توليد الفيديو من النص (Text-to-Video): تطلب وقتاً أطول بمتوسط 258.2 ثانية (~4.3 دقائق) عبر 896 مهمة ناجحة، وسجلت نماذج Kling 3.0 وGrok Text-to-Video استقراراً تقنياً مرتفعاً بنسب إنجاز بلغت 81.4% و83.8% على التوالي.
- مهام الدبلجة ومزامنة الشفاه: استغرقت في المتوسط 333.4 ثانية (~5.5 دقائق) نظراً للمعالجة المزدوجة لحركة الوجه ومسار الصوت.
وعلى صعيد أسباب الرفض بخلاف الضغط الفني للمزودين، سجلت المنصة 153 حالة رفض بسبب فلاتر أمان الأوامر النصية و18 حالة بسبب سياسات فحص الوجوه الصارمة؛ وصياغة الأوامر بدقة تضمن تفادي هذه الإخفاقات.
كيفية صياغة أمر نصي فعال للفيديو
يتطلب فيديو الذكاء الاصطناعي وصف التغير الزمني بوضوح. تتكون المعادلة النموذجية لأي أمر ناجح من خمسة عناصر:
- زاوية الكاميرا ونوع اللقطة: لقطة قريبة (Close-up)، أو تصوير من زاوية منخفضة، أو تتبع بالكاميرا الطائرة.
- العنصر الأساسي: تفاصيل مظهر الشخصية أو خامات المنتج أو طبيعة المكان.
- الحركة والفيزياء: ما يحدث بدقة (مثل: «أمواج تضرب صخوراً داكنة بقوة ويتطاير الرذاذ»).
- مسار الكاميرا: اقتراب بطيء، أو دوران حول الهدف، أو حركة أفقية سلسة.
- الإضاءة والأسلوب: ضوء الساعة الذهبية، أو إضاءة خلفية سينمائية، أو طابع شريط 35 ملم.
وعند تحريك صورة ثابتة، لا تكرر وصف تفاصيل الملابس أو العيون الموجودة بالفعل، بل ركز فقط على الحركة: «تبتسم الشخصية بلطف وتنظر نحو الكاميرا بينما يحرك نسيم خفيف خصلات شعرها مع اقتراب بطيء للكاميرا».
خطوات إنشاء الفيديو على NeuralSpace
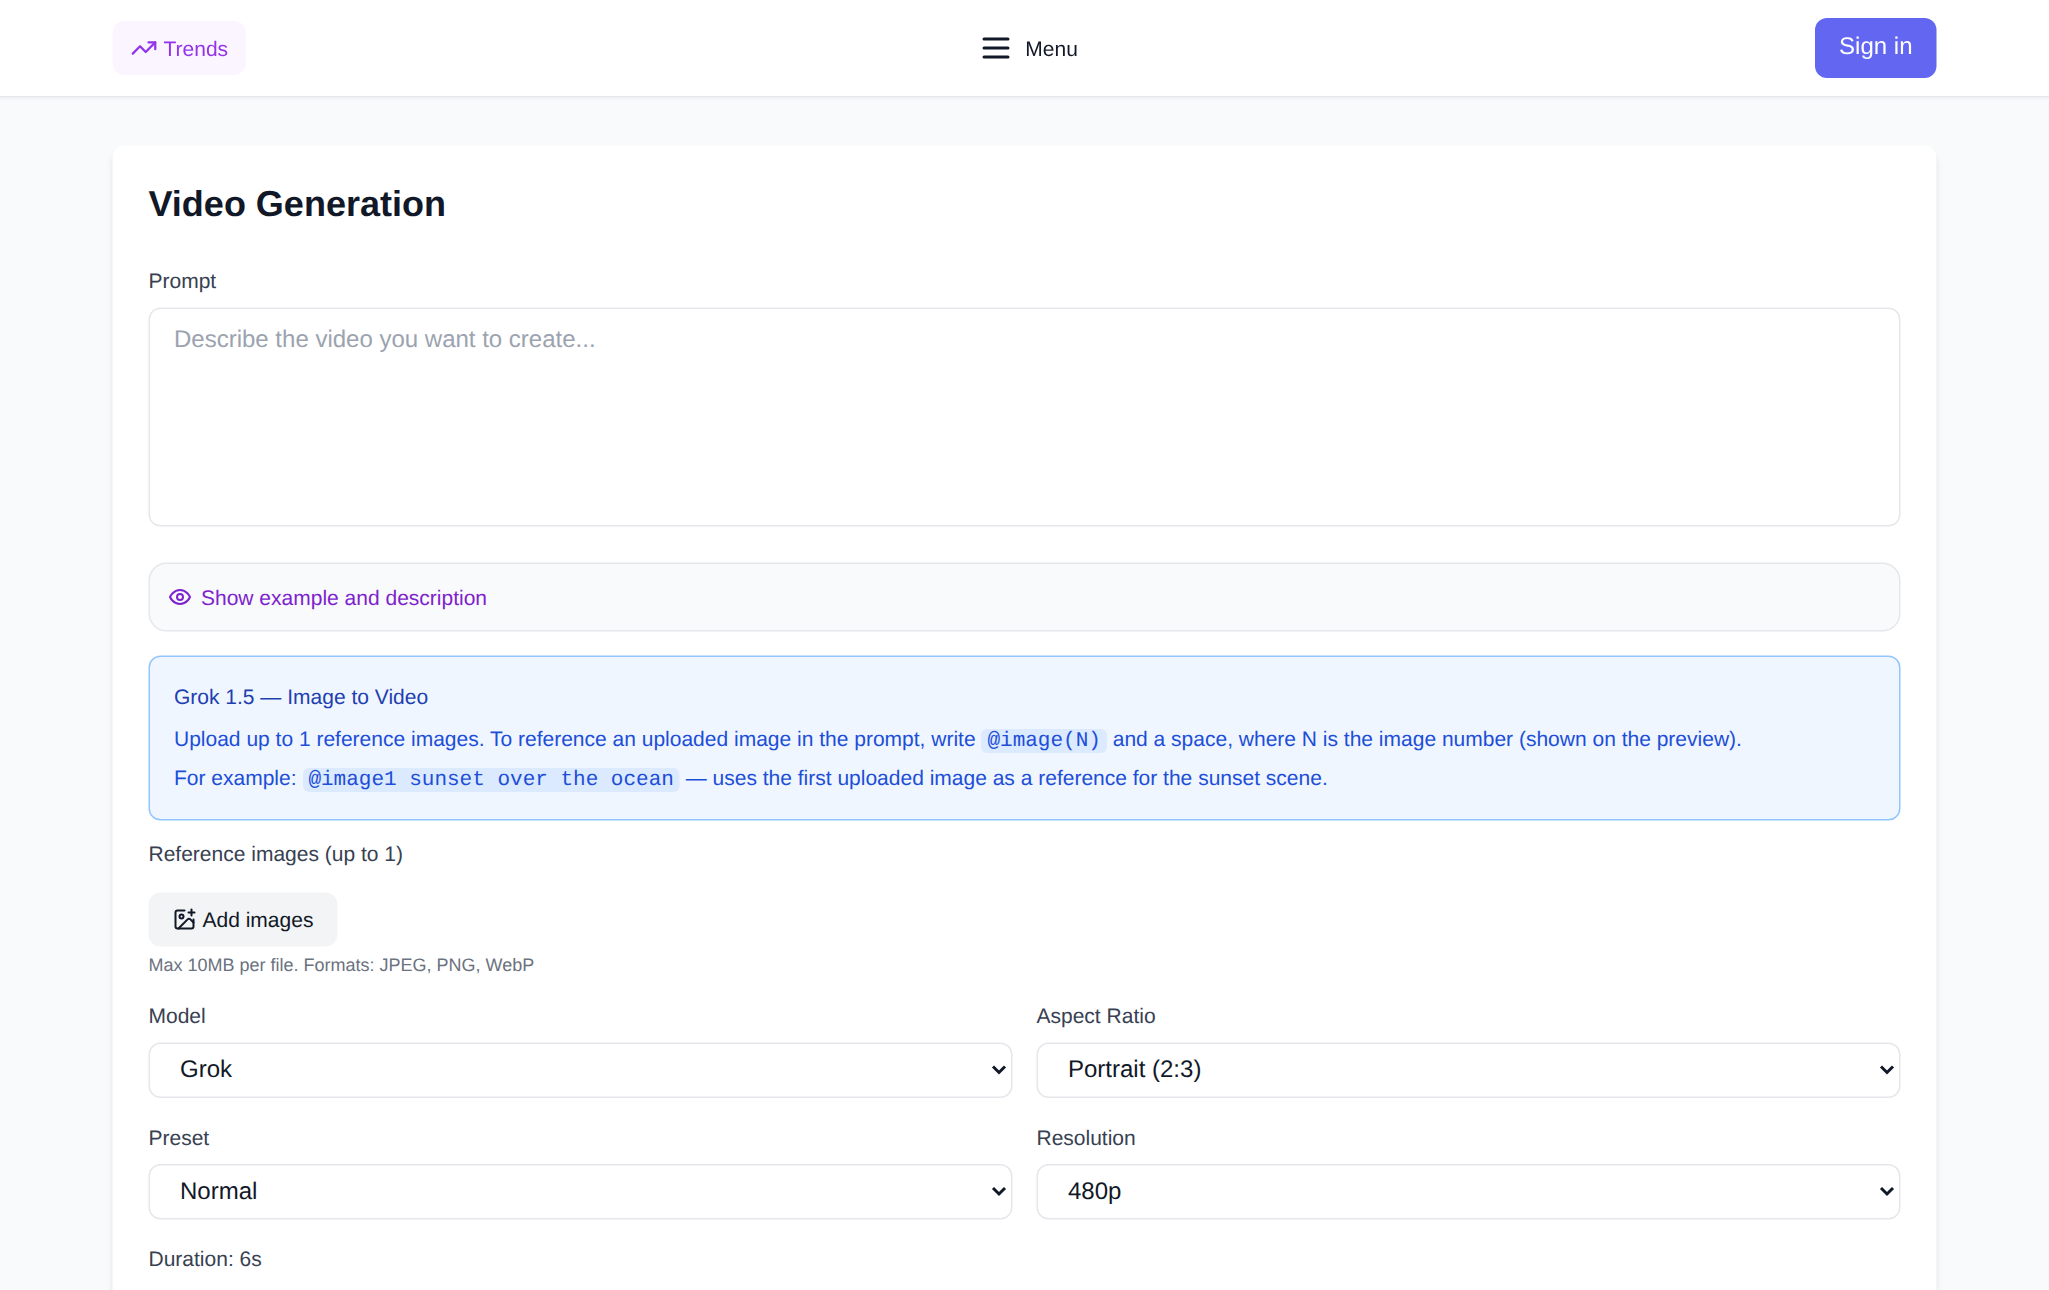
تتم عملية الإنشاء عبر واجهة ويب مباشرة دون الحاجة لبطاقات رسومية أو إعدادات برمجية معقدة:
- افتح قسم الفيديو في الموقع.
- اختر نمط العمل: Text-to-Video للإنشاء من الصفر، أو اسحب صورتك إلى حقل الإدخال لنمط Image-to-Video.
- اختر النموذج المناسب لمتطلباتك (SeeDance 2.5 للمشاهد الطويلة مع الصوت، أو Kling 3.0 للحركات البشرية الواقعية، أو Grok/Wan 2.6 للتحريك الفوري للصور).
- حدد الإعدادات: نسبة العرض إلى الارتفاع (16:9 للشاشات الأفقية، أو 9:16 لمنصات ريلز وشورتس)، والمدة المطلوبة، والدقة.
- اضغط «إنشاء الفيديو»؛ حيث تظهر التكلفة الدقيقة بالرموز على الزر مباشرة قبل التشغيل.
يظهر المقطع المكتمل في مساحة العرض ويُحفظ تلقائياً في سجل الإنشاءات لتنزيله بصيغة MP4 في أي وقت. لا يتطلب NeuralSpace أي اشتراك شهري إلزامي: يُمنح المستخدمون الجدد رموزاً ابتدائية لتجربة الخدمة، وتتم المحاسبة لاحقاً بشفافية مقابل الرموز المستهلكة فقط.
أي النماذج تختار لمشروعك؟
يمتلك كل نموذج نقاط تميز واضحة: إذا كنت بحاجة إلى مقطع طويل مع مؤثرات صوتية مدمجة ودعم لمراجع مرئية متعددة، فإن SeeDance 2.5 هو الخيار الأمثل. وإذا كان تركيزك منصباً على دقة حركة الأشخاص وواقعية حركة الأيدي، فإن Kling 3.0 يتفوق بجدارة. أما لتحريك الرسومات والصور الثابتة بسرعة وثبات عاليين دون تشويه النمط البصري، فإن Grok Image-to-Video وWan 2.6 يقدمان نتائج مذهلة.
الأسئلة الشائعة
ما أفضل نموذج ذكاء اصطناعي لتحريك الصور الشخصية؟
يقدم Kling 3.0 وGrok Image-to-Video أعلى درجات الدقة؛ حيث يحافظان على ملامح الوجه الأصلية وتفاصيل الإضاءة مع إضافة تعبيرات طبيعية وانسيابية.
ما الفرق بين توليد الفيديو من النص وتحريك الصور؟
في نمط النص، يبتكر النموذج المشهد والأشخاص من الصفر، بينما في تحريك الصور يلتزم بالإطار المعطى ويحسب فقط حركة البكسلات خلال الوقت.
كم يستغرق توليد مقطع الفيديو بالذكاء الاصطناعي؟
وفقاً للبيانات الفعلية لمنصة NeuralSpace، يستغرق تحريك الصور في المتوسط 125.4 ثانية (~دقيقتين)، بينما يستغرق التوليد من النص 258.2 ثانية (~4.3 دقائق).
هل أحتاج لاشتراك مدفوع لإنشاء مقاطع الفيديو في NeuralSpace؟
لا يلزم أي اشتراك دوري. يحصل المستخدم الجديد على رموز ابتدائية عند التسجيل، وتتم المحاسبة بالرمز لكل عملية توليد دون أي التزامات شهرية.